
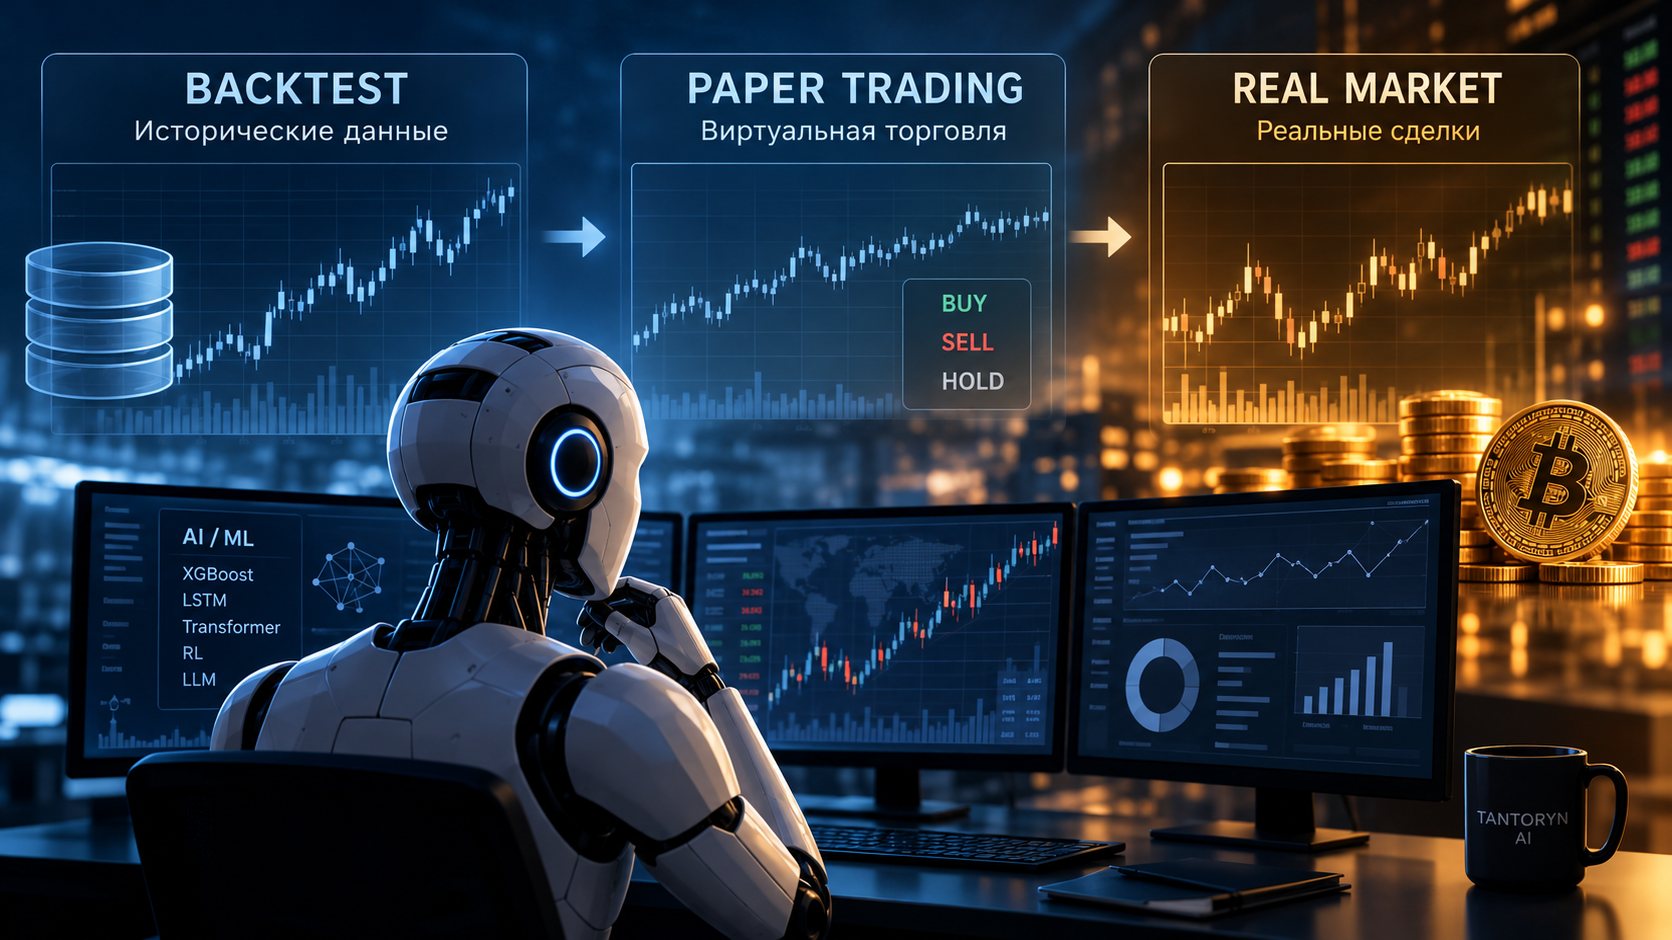
Un modelo de IA para trading puede tener un historial de pruebas brillante y un resultado muy distinto cuando empieza a trabajar con datos nuevos. Pero incluso esa divergencia es fácil de malinterpretar.
A finales de septiembre de 2026 se publicó el trabajo Can AI Make Money in Crypto? Measuring the Gap from Backtests to Real Markets. Su valor no está en ofrecer otro ranking de algoritmos. Los autores compararon cómo rinden los métodos de IA para trading en tres etapas: backtest histórico, operativa virtual sobre infraestructura real de exchange y operaciones con dinero real.
Tres pruebas, tres preguntas distintas
El backtest muestra cómo se habría comportado un algoritmo con datos pasados. Es útil para una primera evaluación de una idea, pero no protege del sobreajuste: si modificas el modelo una y otra vez mirando el periodo de validación, acabas ajustándolo al pasado.
El paper trading (operativa simulada) comprueba si un patrón se mantiene cuando el futuro aún es desconocido. Es una prueba más realista, pero el capital sigue siendo virtual y las condiciones reales de ejecución solo se reproducen en parte.
Las operaciones reales añaden el precio efectivo de ejecución, la liquidez y el slippage. Aunque el algoritmo no haya cambiado, el resultado puede hacerlo.
Cada etapa pone a prueba un nuevo conjunto de supuestos. El éxito en una no garantiza el éxito en la siguiente.
Qué encontraron los investigadores
Los autores analizaron 32 métodos: machine learning clásico, aprendizaje por refuerzo, grandes modelos de lenguaje (LLM) y agentes de trading.
Con datos históricos de 2025, 23 de los 24 métodos de ML obtuvieron rentabilidad positiva. Las demás familias, no.
Después, los métodos se seleccionaron para operar de forma virtual del 4 de junio al 21 de septiembre de 2026, y el panorama se invirtió: de los ocho métodos de ML, solo dos siguieron siendo rentables, mientras que los seis métodos de las otras familias cerraron el periodo en positivo.
Aquí es fácil sacar una conclusión de titular: «el ML clásico pierde frente a los LLM». Pero sería prematuro. Los periodos de backtest y de operativa virtual son distintos, y a la segunda etapa solo pasaron quienes ya habían destacado antes. Una tabla así mezcla tres factores: el cambio del mercado, el efecto de selección y las condiciones de ejecución.
Lo más importante: la comparación en un mismo periodo
Para eliminar al menos el factor de los «mercados distintos», los autores compararon el backtest y la operativa virtual de 14 métodos en un mismo intervalo: del 4 de junio al 21 de septiembre de 2026.
| Método | Backtest | Paper trading |
|---|---|---|
| XGBoost | +33,95 % | +27,53 % |
| QWEN | +11,35 % | +37,77 % |
En XGBoost, la operativa virtual quedó por debajo de la simulación. En QWEN ocurrió lo contrario: 26,42 puntos porcentuales por encima. Es más, 10 de los 14 métodos obtuvieron en paper trading un resultado superior al del backtest.
Es un detalle importante: el problema no es que el backtest siempre sobrestime. Puede equivocarse en ambas direcciones, tanto en la rentabilidad como en el riesgo.
Por qué el paper trading todavía no es el mercado real
Cuatro métodos llegaron a operar con dinero real. Se probaron del 24 de agosto al 21 de septiembre de 2026.
Solo uno de los cuatro obtuvo beneficios. Y ninguno superó a la simple tenencia de Bitcoin en el mismo periodo.
La ejecución resulta especialmente reveladora: la desviación media del precio pasó de 0,31 ‰ en la operativa virtual a 1,86 ‰ en la real, casi seis veces más.
Aun así, hay que mantener la escala de las conclusiones. Cuatro métodos y cuatro semanas son demasiado poco para declarar inservible a toda una familia de algoritmos. Y superar a Bitcoin no es un criterio universal: las estrategias tienen riesgos y objetivos distintos.
Otro problema: cómo se selecciona a los participantes
Si de un grupo grande de algoritmos solo pasan a la siguiente etapa los ganadores históricos, aparece un riesgo de sesgo. Algunos pudieron ganar no gracias a un patrón estable, sino a una combinación afortunada de condiciones de mercado. Al volver a probarlos, esa ventaja puede desaparecer.
El problema se conoce desde hace tiempo. Ya en 2010, Gavin Cawley y Nicola Talbot mostraron en el estudio On Over-fitting in Model Selection and Subsequent Selection Bias in Performance Evaluation que el sobreajuste no se produce solo al entrenar un modelo, sino también al elegirlo según una métrica. Por eso no basta con controlar el entrenamiento: también hay que controlar el propio mecanismo de selección de ganadores.
Qué relación tiene con Tantoryn AI
Para nosotros es una cuestión práctica. En el proyecto Tantoryn AI, la investigación de modelos de ML, la evaluación de candidatos de trading y el funcionamiento del circuito virtual están separados.
En el informe del 5 al 9 de octubre describimos los primeros resultados de la búsqueda de señales autónomas basadas en el estado del mercado. Varios candidatos no superaron la validación, y se detectó y corrigió un error en la preparación de los datos. No presentamos esos resultados como prueba de que un modelo esté listo para operar.
El actual circuito público de trading funciona con operaciones virtuales. Las órdenes reales están desactivadas. Por eso, sus observaciones no pueden considerarse una rentabilidad demostrada con capital real. Y a la inversa: el fracaso de un candidato de investigación concreto no determina por sí solo la calidad de todo el circuito; son objetos de evaluación distintos.
El nuevo estudio externo no confirma ni refuta los modelos de Tantoryn AI. Lo realizaron otros autores, con otros métodos y en otro entorno. Para nosotros, su valor está en una pregunta más precisa: ¿qué debe demostrar exactamente cada nuevo nivel de validación antes de que puedan basarse en él afirmaciones más sólidas?
Cómo leer las afirmaciones sobre una IA de trading exitosa
Cuando un desarrollador dice que un modelo ha mostrado una alta precisión o beneficios, no basta con mirar la cifra final.
Hay que entender cuándo se eligieron el modelo y sus parámetros, si los resultados de prueba se usaron para cambios posteriores y hasta qué punto fue independiente la verificación final. Y si las condiciones son comparables: el periodo de mercado, los costes y las reglas de ejecución.
Y, sobre todo, distinguir el estatus de la evidencia. El backtest, la operativa virtual y las operaciones reales no son tres nombres para la misma prueba. Cada etapa añade nuevos supuestos y tiene sus propias limitaciones.
Un resultado sólido no es solo una métrica alta. Es la capacidad de explicar con precisión qué demuestra, en qué condiciones se obtuvo y qué preguntas siguen abiertas.
Este artículo trata sobre metodología de investigación. No constituye una recomendación de inversión ni contiene afirmaciones sobre la rentabilidad de Tantoryn AI.
Fuentes
1. Xingtong Yu et al. Can AI Make Money in Crypto? Measuring the Gap from Backtests to Real Markets. 28 de septiembre de 2026. Preprint científico. Fuente principal de los resultados numéricos y de la descripción de las tres etapas de validación.
2. Gavin Cawley, Nicola Talbot. On Over-fitting in Model Selection and Subsequent Selection Bias in Performance Evaluation. Journal of Machine Learning Research, 2010. Estudio sobre el sesgo en la selección de modelos.
3. Tantoryn AI: cinco días de investigación en ML — errores, verificaciones y los primeros resultados negativos. 10 de octubre de 2026. Informe oficial del proyecto sobre su trabajo de investigación.
4. Sitio web oficial de Tantoryn AI. Estado público del proyecto y de su circuito de trading virtual.