
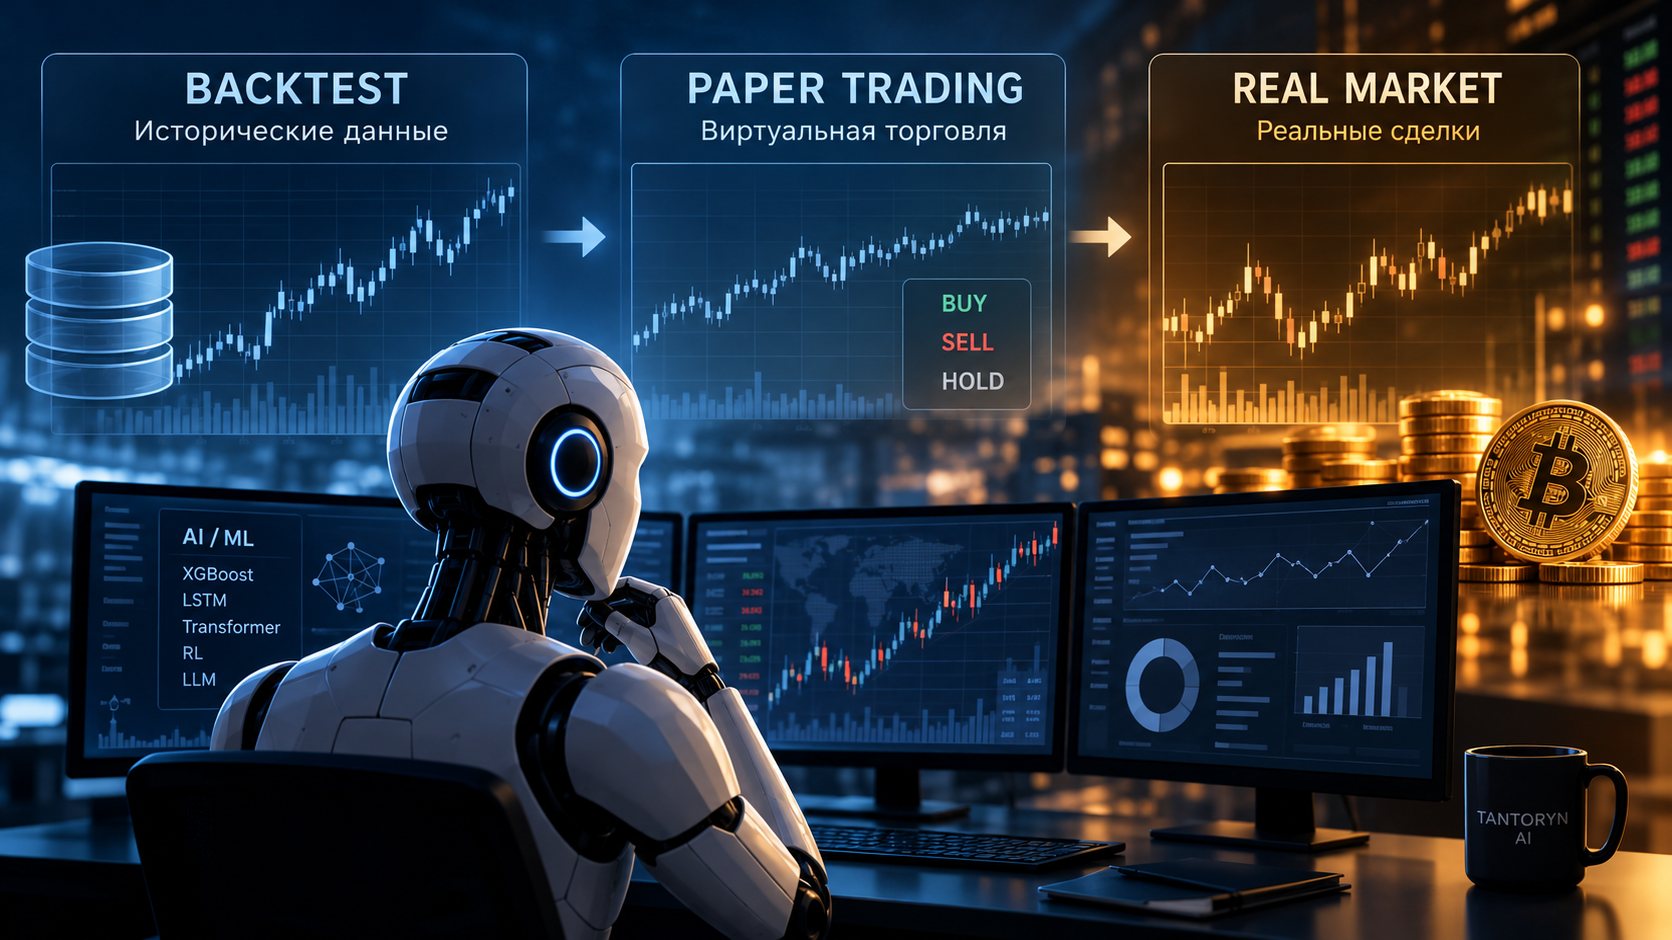
У торговой AI-модели может быть красивая история тестов — и совсем другой результат, когда она начинает работать на новых данных. Но даже это расхождение легко понять неправильно.
В конце сентября 2026 года вышла работа Can AI Make Money in Crypto? Measuring the Gap from Backtests to Real Markets. Её ценность не в очередном рейтинге алгоритмов. Авторы сравнили, как торговые AI-методы работают на трёх этапах: исторический бэктест, виртуальная торговля на биржевой инфраструктуре и реальные деньги.
Три проверки — три разных вопроса
Бэктест показывает, как алгоритм вёл бы себя на прошлых данных. Он полезен для первой оценки идеи, но не спасает от переобучения: если вы много раз меняете модель, ориентируясь на проверочный период, вы подстраиваетесь под прошлое.
Paper trading (виртуальная торговля) проверяет, сохраняется ли закономерность, когда будущее ещё неизвестно. Это более реалистичная проверка, но капитал остаётся виртуальным, и реальные условия исполнения воспроизводятся не полностью.
Реальные сделки добавляют фактическую цену исполнения, ликвидность и проскальзывание. Даже если алгоритм не менялся, результат может измениться.
Каждый следующий этап проверяет новую группу допущений. Успех на предыдущем не гарантирует успех на следующем.
Что нашли исследователи
Авторы рассмотрели 32 метода: классический ML, reinforcement learning, LLM и торговых агентов.
На исторических данных за 2025 год 23 из 24 ML-методов показали положительную доходность. Другие семейства — нет.
Затем методы отобрали для виртуальной торговли с 4 июня по 21 сентября 2026 года. Картина перевернулась: из восьми ML-методов прибыль сохранили только два. А все шесть методов из других семейств закрыли период в плюсе.
Здесь легко сделать громкий вывод: «Классический ML проигрывает LLM». Но это было бы преждевременно. Периоды бэктеста и виртуальной торговли разные, и для второго этапа отбирали тех, кто уже хорошо показал себя раньше. В такой таблице смешаны три фактора: изменение рынка, эффект отбора и условия исполнения.
Самое важное: сравнение на одном периоде
Чтобы убрать хотя бы фактор «разных рынков», авторы сравнили бэктест и виртуальную торговлю для 14 методов на одном и том же интервале — с 4 июня по 21 сентября 2026 года.
| Метод | Бэктест | Paper trading |
|---|---|---|
| XGBoost | +33,95% | +27,53% |
| QWEN | +11,35% | +37,77% |
У XGBoost виртуальная торговля оказалась хуже симуляции. У QWEN — наоборот, лучше на 26,42 процентного пункта. Более того, 10 из 14 методов в paper trading показали результат выше, чем в бэктесте.
Это важная деталь: проблема не в том, что бэктест всегда завышает. Он может ошибаться в обе стороны — и по доходности, и по риску.
Почему paper trading — ещё не реальный рынок
До реальных денег дошли четыре метода. Тестировали с 24 августа по 21 сентября 2026 года.
Прибыль показал только один из четырёх. И ни один не обогнал простое удержание Bitcoin за тот же период.
Особенно показательно исполнение: среднее отклонение цены выросло с 0,31‰ в виртуальной торговле до 1,86‰ в реальной. Это почти в шесть раз больше.
Но масштаб выводов надо сохранять. Четыре метода и четыре недели — слишком мало, чтобы объявлять целое семейство алгоритмов непригодным. И превосходство над Bitcoin — не универсальный критерий: у стратегий разные риски и задачи.
Ещё одна проблема: как отбирают участников
Если из большой группы алгоритмов на следующий этап берут только исторических победителей, возникает риск смещения. Кто-то выиграл не благодаря устойчивой закономерности, а из-за удачного сочетания рыночных условий. При повторной проверке это преимущество может исчезнуть.
Проблема известна давно. Ещё в 2010 году Gavin Cawley и Nicola Talbot в исследовании On Over-fitting in Model Selection and Subsequent Selection Bias in Performance Evaluation показали, что переобучение происходит не только при обучении модели, но и при её выборе по метрике. Поэтому контролировать нужно не только обучение, но и сам механизм отбора победителей.
Как это связано с Tantoryn AI
Для нас этот вопрос практический. В проекте Tantoryn AI разделены исследования ML-моделей, оценка торговых кандидатов и работа виртуального контура.
В отчёте за 5–9 октября мы описали первые результаты поиска самостоятельных сигналов по состоянию рынка. Несколько кандидатов не прошли проверку, а в подготовке данных была найдена и исправлена ошибка. Мы не представляли эти результаты как доказательство готовности модели к торговле.
Текущий публичный торговый контур работает с виртуальными сделками. Реальные ордера отключены. Поэтому его наблюдения нельзя считать доказанной доходностью на реальном капитале. И наоборот: провал отдельного исследовательского кандидата сам по себе не определяет качество всего контура — это разные объекты оценки.
Новое внешнее исследование не подтверждает и не опровергает модели Tantoryn AI. Оно сделано другими авторами, на других методах и в другой среде. Для нас его ценность — в более точном вопросе: что именно должен доказать каждый следующий уровень проверки, прежде чем на его основе можно будет делать более сильные заявления?
Как читать заявления об успешном торговом ИИ
Когда разработчик говорит, что модель показала высокую точность или прибыль, мало смотреть на итоговую цифру.
Нужно понять: когда выбирались модель и параметры, не использовались ли тестовые результаты для последующих изменений, насколько независимой была финальная проверка. Сопоставимы ли условия: рыночный период, издержки, правила исполнения.
И главное — различать статус доказательства. Бэктест, виртуальная торговля и реальные сделки — это не три названия одного теста. Каждый этап добавляет новые допущения и имеет свои ограничения.
Сильный результат — это не только высокая метрика. Это возможность точно объяснить, что она доказывает, при каких условиях получена и какие вопросы остаются открытыми.
Материал посвящён методологии исследований. Он не является инвестиционной рекомендацией и не содержит утверждений о прибыльности Tantoryn AI.
Источники
1. Xingtong Yu и соавторы. Can AI Make Money in Crypto? Measuring the Gap from Backtests to Real Markets. 28 сентября 2026 года. Научный препринт. Основной источник численных результатов и описания трёх этапов проверки.
2. Gavin Cawley, Nicola Talbot. On Over-fitting in Model Selection and Subsequent Selection Bias in Performance Evaluation. Journal of Machine Learning Research, 2010. Исследование смещения при выборе моделей.
3. Tantoryn AI: пять дней исследований ML — ошибки, проверки и первые отрицательные результаты. 10 октября 2026 года. Официальный отчёт об исследовательской работе проекта.
4. Официальный сайт Tantoryn AI. Публичный статус проекта и виртуального торгового контура.