
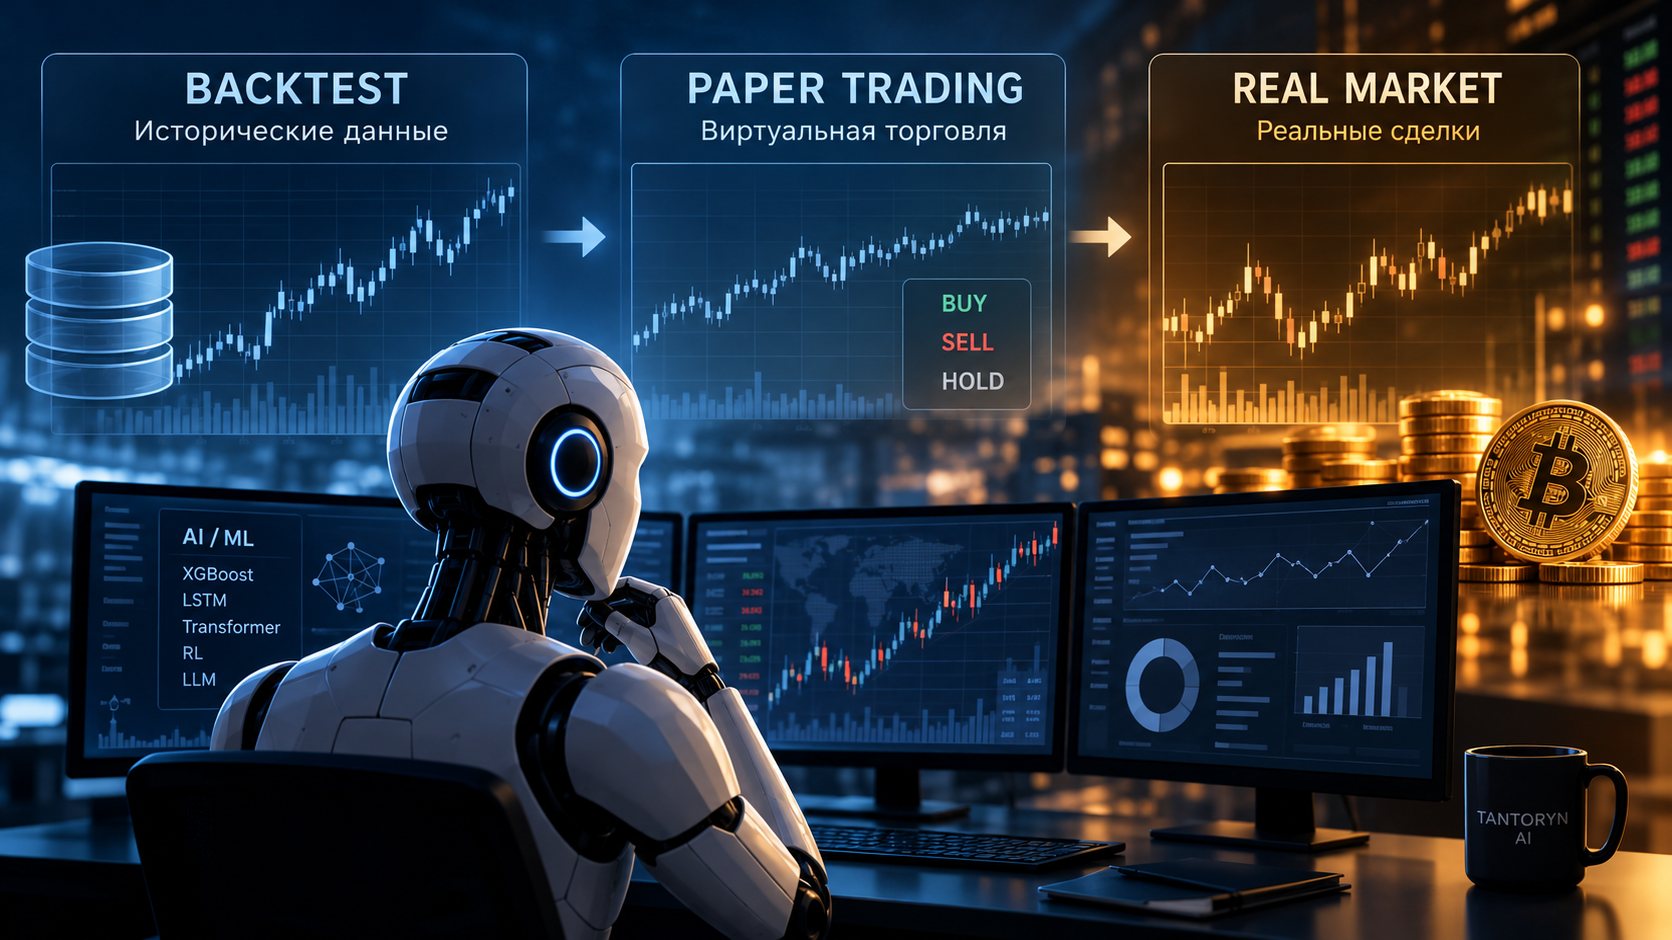
Um modelo de IA para trading pode ter um histórico de testes impressionante e um resultado bem diferente quando passa a operar com dados novos. Mas até essa divergência é fácil de interpretar errado.
No fim de setembro de 2026 foi publicado o trabalho Can AI Make Money in Crypto? Measuring the Gap from Backtests to Real Markets. Seu valor não está em mais um ranking de algoritmos. Os autores compararam o desempenho de métodos de IA para trading em três etapas: backtest histórico, negociação virtual em infraestrutura real de corretora e operações com dinheiro real.
Três etapas, três perguntas diferentes
O backtest mostra como um algoritmo teria se comportado com dados passados. Ele é útil para uma primeira avaliação de uma ideia, mas não protege contra o overfitting: se você ajusta o modelo repetidas vezes olhando para o período de validação, acaba moldando-o ao passado.
O paper trading (negociação simulada) verifica se um padrão se mantém quando o futuro ainda é desconhecido. É um teste mais realista, mas o capital continua virtual e as condições reais de execução são reproduzidas apenas em parte.
As operações reais acrescentam o preço efetivo de execução, a liquidez e o slippage. Mesmo que o algoritmo não tenha mudado, o resultado pode mudar.
Cada etapa testa um novo conjunto de premissas. O sucesso em uma etapa não garante o sucesso na seguinte.
O que os pesquisadores encontraram
Os autores analisaram 32 métodos: machine learning clássico, aprendizado por reforço, modelos de linguagem de grande porte (LLMs) e agentes de trading.
Nos dados históricos de 2025, 23 dos 24 métodos de ML tiveram retorno positivo. As demais famílias, não.
Em seguida, os métodos foram selecionados para negociação virtual de 4 de junho a 21 de setembro de 2026. O quadro se inverteu: dos oito métodos de ML, apenas dois continuaram lucrativos, enquanto todos os seis métodos das outras famílias fecharam o período no positivo.
Aqui é fácil tirar uma conclusão de manchete: “o ML clássico perde para os LLMs”. Mas seria prematuro. Os períodos de backtest e de negociação virtual são diferentes, e para a segunda etapa foram escolhidos apenas os que já tinham ido bem antes. Uma tabela assim mistura três fatores: mudança do mercado, efeito de seleção e condições de execução.
O ponto central: a comparação no mesmo período
Para eliminar pelo menos o fator “mercados diferentes”, os autores compararam backtest e negociação virtual de 14 métodos no mesmo intervalo — de 4 de junho a 21 de setembro de 2026.
| Método | Backtest | Paper trading |
|---|---|---|
| XGBoost | +33,95% | +27,53% |
| QWEN | +11,35% | +37,77% |
No XGBoost, a negociação virtual ficou abaixo da simulação. No QWEN, foi o contrário: 26,42 pontos percentuais acima. Mais do que isso, 10 dos 14 métodos tiveram resultado superior no paper trading em relação ao backtest.
Esse detalhe é importante: o problema não é que o backtest sempre superestime. Ele pode errar para os dois lados — tanto no retorno quanto no risco.
Por que o paper trading ainda não é o mercado real
Quatro métodos chegaram ao dinheiro real. Eles foram testados de 24 de agosto a 21 de setembro de 2026.
Apenas um dos quatro teve lucro. E nenhum superou a simples manutenção de Bitcoin no mesmo período.
A execução é especialmente reveladora: o desvio médio de preço subiu de 0,31‰ na negociação virtual para 1,86‰ na real — quase seis vezes mais.
Mas é preciso manter a proporção das conclusões. Quatro métodos e quatro semanas são pouco demais para declarar inadequada toda uma família de algoritmos. E superar o Bitcoin não é um critério universal: as estratégias têm riscos e objetivos diferentes.
Outro problema: como os participantes são selecionados
Se, de um grande grupo de algoritmos, apenas os vencedores históricos avançam para a etapa seguinte, surge o risco de viés. Alguns podem ter vencido não por um padrão consistente, mas por uma combinação favorável de condições de mercado. Em um novo teste, essa vantagem pode desaparecer.
O problema é conhecido há muito tempo. Já em 2010, Gavin Cawley e Nicola Talbot mostraram, no estudo On Over-fitting in Model Selection and Subsequent Selection Bias in Performance Evaluation, que o overfitting ocorre não só no treinamento do modelo, mas também na sua escolha com base em uma métrica. Por isso é preciso controlar não apenas o treinamento, mas o próprio mecanismo de seleção dos vencedores.
Qual é a relação com a Tantoryn AI
Para nós, essa é uma questão prática. No projeto Tantoryn AI, a pesquisa de modelos de ML, a avaliação de candidatos a operação e o funcionamento do circuito virtual são separados.
No relatório de 5 a 9 de outubro, descrevemos os primeiros resultados da busca por sinais autônomos baseados no estado do mercado. Vários candidatos não passaram na validação, e um erro na preparação dos dados foi encontrado e corrigido. Não apresentamos esses resultados como prova de que um modelo está pronto para operar.
O atual circuito público de trading opera com operações virtuais. As ordens reais estão desativadas. Por isso, suas observações não podem ser consideradas rentabilidade comprovada com capital real. E o inverso também vale: o fracasso de um candidato de pesquisa isolado não determina, por si só, a qualidade de todo o circuito — são objetos de avaliação diferentes.
O novo estudo externo não confirma nem refuta os modelos da Tantoryn AI. Ele foi feito por outros autores, com outros métodos e em outro ambiente. Para nós, seu valor está em uma pergunta mais precisa: o que exatamente cada nível seguinte de validação precisa provar antes que se possam fazer afirmações mais fortes com base nele?
Como ler alegações sobre IA de trading bem-sucedida
Quando um desenvolvedor diz que um modelo mostrou alta precisão ou lucro, não basta olhar para o número final.
É preciso entender quando o modelo e seus parâmetros foram escolhidos, se os resultados de teste foram usados para alterações posteriores e quão independente foi a verificação final. E se as condições são comparáveis: o período de mercado, os custos e as regras de execução.
E, acima de tudo, distinguir o status da evidência. Backtest, negociação virtual e operações reais não são três nomes para o mesmo teste. Cada etapa acrescenta novas premissas e tem suas próprias limitações.
Um resultado forte não é apenas uma métrica alta. É a capacidade de explicar com precisão o que ela prova, em que condições foi obtida e quais perguntas continuam em aberto.
Este material trata de metodologia de pesquisa. Não constitui recomendação de investimento e não contém afirmações sobre a rentabilidade da Tantoryn AI.
Fontes
1. Xingtong Yu et al. Can AI Make Money in Crypto? Measuring the Gap from Backtests to Real Markets. 28 de setembro de 2026. Preprint científico. Fonte principal dos resultados numéricos e da descrição das três etapas de validação.
2. Gavin Cawley, Nicola Talbot. On Over-fitting in Model Selection and Subsequent Selection Bias in Performance Evaluation. Journal of Machine Learning Research, 2010. Estudo sobre o viés na seleção de modelos.
3. Tantoryn AI: cinco dias de pesquisa em ML — erros, verificações e os primeiros resultados negativos. 10 de outubro de 2026. Relatório oficial do projeto sobre seu trabalho de pesquisa.
4. Site oficial da Tantoryn AI. Status público do projeto e do circuito de trading virtual.