
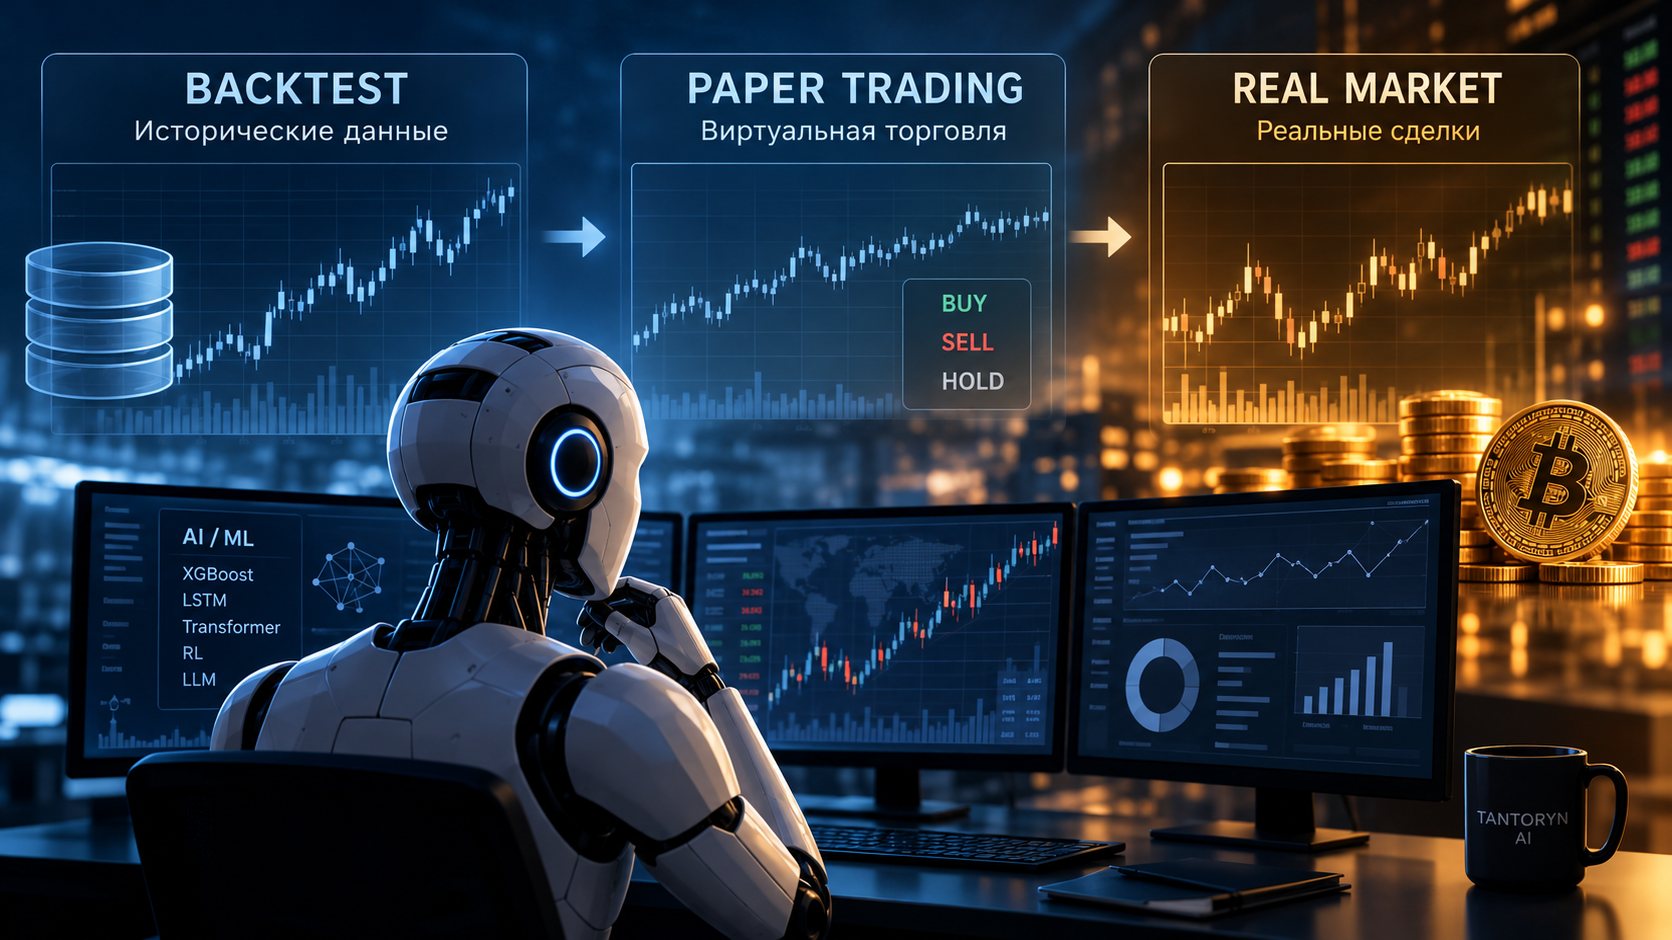
Bir alım-satım yapay zekâ modelinin test geçmişi parlak görünebilir — yeni veriler üzerinde çalışmaya başladığında ise sonuç bambaşka olabilir. Ama bu farkı bile yanlış yorumlamak kolaydır.
Eylül 2026'nın sonunda Can AI Make Money in Crypto? Measuring the Gap from Backtests to Real Markets başlıklı çalışma yayımlandı. Değeri, algoritmaların bir başka sıralamasını sunmasında değil. Yazarlar, yapay zekâ alım-satım yöntemlerinin üç aşamadaki performansını karşılaştırdı: geçmiş verilerle backtest, gerçek borsa altyapısında sanal işlem ve gerçek parayla işlem.
Üç test, üç farklı soru
Backtest, bir algoritmanın geçmiş veriler üzerinde nasıl davranmış olacağını gösterir. Bir fikrin ilk değerlendirmesi için faydalıdır, ancak aşırı öğrenmeye (overfitting) karşı koruma sağlamaz: modeli doğrulama dönemine bakarak tekrar tekrar değiştirirseniz, onu geçmişe uydurmuş olursunuz.
Paper trading (sanal işlem), gelecek henüz bilinmezken bir örüntünün korunup korunmadığını test eder. Daha gerçekçi bir sınamadır, ancak sermaye sanal kalır ve gerçek emir gerçekleşme koşulları yalnızca kısmen yeniden üretilir.
Gerçek işlemler, fiili gerçekleşme fiyatını, likiditeyi ve kaymayı (slippage) devreye sokar. Algoritma değişmemiş olsa bile sonuç değişebilir.
Her aşama yeni bir varsayım grubunu sınar. Bir aşamadaki başarı, bir sonrakinde başarıyı garanti etmez.
Araştırmacılar ne buldu
Yazarlar 32 yöntemi inceledi: klasik makine öğrenmesi, pekiştirmeli öğrenme, büyük dil modelleri (LLM) ve alım-satım ajanları.
2025 yılına ait geçmiş verilerde 24 ML yönteminden 23'ü pozitif getiri gösterdi. Diğer aileler göstermedi.
Ardından yöntemler 4 Haziran–21 Eylül 2026 dönemindeki sanal işlem için seçildi ve tablo tersine döndü: sekiz ML yönteminden yalnızca ikisi kârlılığını korudu. Diğer ailelerin altı yönteminin tamamı ise dönemi artıda kapattı.
Burada iddialı bir sonuca varmak kolay: “Klasik ML, LLM'lere kaybediyor.” Ama bu erken bir yargı olur. Backtest ve sanal işlem dönemleri farklı; ikinci aşamaya ise önceden iyi performans göstermiş olanlar seçildi. Böyle bir tabloda üç etken iç içe geçer: piyasadaki değişim, seçim etkisi ve gerçekleşme koşulları.
En önemlisi: aynı dönemde karşılaştırma
En azından “farklı piyasalar” etkenini ortadan kaldırmak için yazarlar, 14 yöntemin backtest ve sanal işlem sonuçlarını aynı aralıkta — 4 Haziran–21 Eylül 2026 — karşılaştırdı.
| Yöntem | Backtest | Paper trading |
|---|---|---|
| XGBoost | +%33,95 | +%27,53 |
| QWEN | +%11,35 | +%37,77 |
XGBoost'ta sanal işlem, simülasyonun gerisinde kaldı. QWEN'de ise tersi oldu: 26,42 puan daha iyi. Dahası, 14 yöntemden 10'u paper trading'de backtest'tekinden daha yüksek sonuç elde etti.
Bu önemli bir ayrıntı: sorun, backtest'in her zaman olduğundan iyi göstermesi değil. Backtest her iki yönde de yanılabilir — hem getiride hem de riskte.
Paper trading neden henüz gerçek piyasa değil
Gerçek paraya dört yöntem ulaştı. 24 Ağustos–21 Eylül 2026 arasında test edildiler.
Dört yöntemden yalnızca biri kâr etti. Hiçbiri de aynı dönemde Bitcoin'i basitçe elde tutmanın önüne geçemedi.
Emir gerçekleşmesi özellikle dikkat çekici: ortalama fiyat sapması sanal işlemdeki binde 0,31'den gerçek işlemde binde 1,86'ya çıktı. Bu, neredeyse altı kat artış demek.
Yine de sonuçların ölçeğini korumak gerekiyor. Dört yöntem ve dört hafta, bütün bir algoritma ailesini işe yaramaz ilan etmek için çok az. Bitcoin'i geçmek de evrensel bir ölçüt değil: stratejilerin riskleri ve hedefleri farklıdır.
Bir sorun daha: katılımcılar nasıl seçiliyor
Büyük bir algoritma grubundan bir sonraki aşamaya yalnızca geçmişin kazananları alınırsa, yanlılık riski doğar. Bazıları kalıcı bir örüntü sayesinde değil, piyasa koşullarının şanslı bir bileşimi sayesinde kazanmış olabilir. Yeniden test edildiğinde bu üstünlük kaybolabilir.
Sorun uzun zamandır biliniyor. Daha 2010'da Gavin Cawley ve Nicola Talbot, On Over-fitting in Model Selection and Subsequent Selection Bias in Performance Evaluation başlıklı çalışmalarında aşırı öğrenmenin yalnızca model eğitilirken değil, bir metriğe göre seçilirken de ortaya çıktığını gösterdi. Bu nedenle yalnızca eğitimi değil, kazananları seçme mekanizmasının kendisini de denetlemek gerekir.
Bunun Tantoryn AI ile bağlantısı
Bizim için bu pratik bir soru. Tantoryn AI projesinde ML modeli araştırmaları, işlem adaylarının değerlendirilmesi ve sanal işlem devresinin çalışması birbirinden ayrılmıştır.
5–9 Ekim raporunda piyasa durumuna dayalı bağımsız sinyal arayışımızın ilk sonuçlarını anlattık. Birkaç aday doğrulamayı geçemedi, veri hazırlığında ise bir hata bulunup düzeltildi. Bu sonuçları bir modelin işleme hazır olduğunun kanıtı olarak sunmadık.
Mevcut herkese açık alım-satım devresi sanal işlemlerle çalışıyor. Gerçek emirler devre dışı. Bu yüzden gözlemleri, gerçek sermayede kanıtlanmış getiri olarak kabul edilemez. Tersi de geçerli: tek bir araştırma adayının başarısızlığı, tek başına tüm devrenin kalitesini belirlemez — bunlar farklı değerlendirme nesneleridir.
Yeni dış çalışma, Tantoryn AI modellerini ne doğruluyor ne de çürütüyor. Başka yazarlar tarafından, başka yöntemlerle ve farklı bir ortamda yapıldı. Bizim için değeri daha net bir soruda yatıyor: daha güçlü iddialar ortaya koymadan önce her bir sonraki doğrulama düzeyi tam olarak neyi kanıtlamalı?
Başarılı alım-satım yapay zekâsı iddiaları nasıl okunmalı
Bir geliştirici, modelin yüksek doğruluk ya da kâr gösterdiğini söylediğinde yalnızca nihai rakama bakmak yetmez.
Model ve parametrelerinin ne zaman seçildiğini, test sonuçlarının sonraki değişiklikler için kullanılıp kullanılmadığını ve nihai kontrolün ne kadar bağımsız olduğunu anlamak gerekir. Ayrıca koşulların karşılaştırılabilir olup olmadığını: piyasa dönemi, maliyetler, gerçekleşme kuralları.
En önemlisi de kanıtın statüsünü ayırt etmek. Backtest, sanal işlem ve gerçek işlemler aynı testin üç farklı adı değildir. Her aşama yeni varsayımlar ekler ve kendi sınırlamalarına sahiptir.
Güçlü bir sonuç yalnızca yüksek bir metrik değildir. Bu metriğin tam olarak neyi kanıtladığını, hangi koşullarda elde edildiğini ve hangi soruların açık kaldığını kesin biçimde açıklayabilmektir.
Bu içerik araştırma metodolojisine ayrılmıştır. Yatırım tavsiyesi değildir ve Tantoryn AI'nin kârlılığına ilişkin herhangi bir iddia içermez.
Kaynaklar
1. Xingtong Yu ve diğerleri. Can AI Make Money in Crypto? Measuring the Gap from Backtests to Real Markets. 28 Eylül 2026. Bilimsel ön baskı (preprint). Sayısal sonuçların ve üç doğrulama aşamasının tanımının ana kaynağı.
2. Gavin Cawley, Nicola Talbot. On Over-fitting in Model Selection and Subsequent Selection Bias in Performance Evaluation. Journal of Machine Learning Research, 2010. Model seçimindeki yanlılık üzerine bir çalışma.
3. Tantoryn AI: Beş Günlük ML Araştırması — Hatalar, Kontroller ve İlk Olumsuz Sonuçlar. 10 Ekim 2026. Projenin araştırma çalışmalarına ilişkin resmi raporu.
4. Tantoryn AI resmi web sitesi. Projenin ve sanal işlem devresinin herkese açık durumu.