
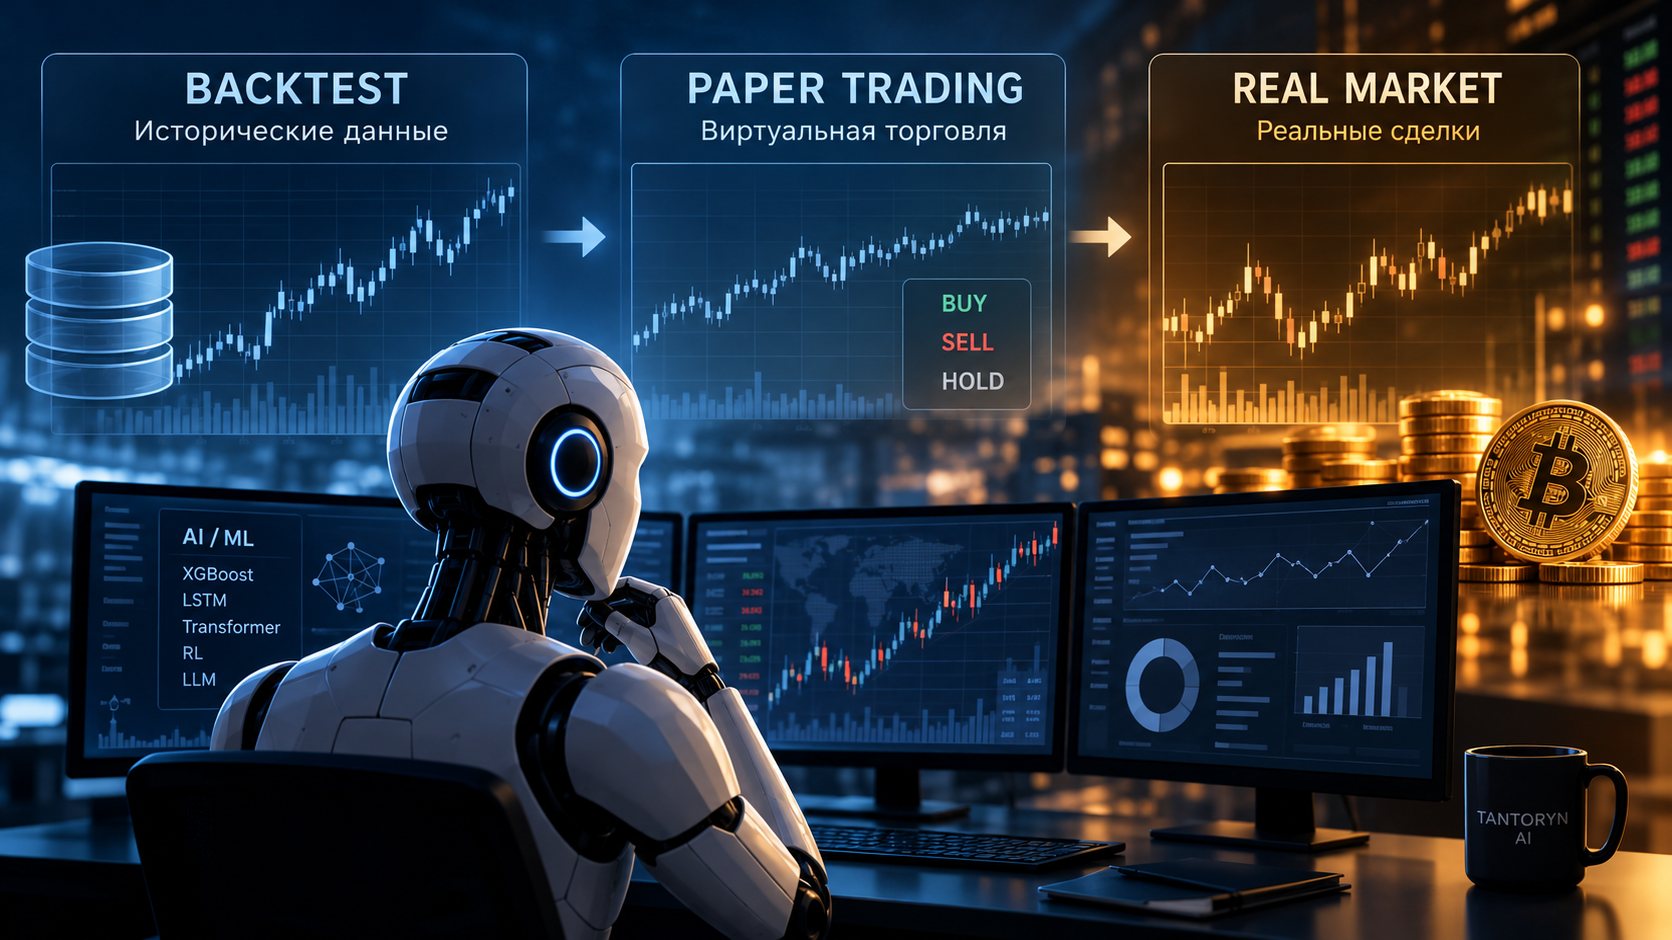
一个交易 AI 模型的测试记录可能非常漂亮,而一旦开始在新数据上运行,结果却可能完全不同。但即便是这种差距,也很容易被误读。
2026 年 9 月底,论文 Can AI Make Money in Crypto? Measuring the Gap from Backtests to Real Markets 发布。它的价值并不在于又给出一份算法排行榜。作者比较了 AI 交易方法在三个阶段的表现:历史回测、基于真实交易所基础设施的模拟交易,以及真实资金交易。
三种检验,三个不同的问题
回测展示的是算法在过去数据上本会如何表现。它适合对一个想法做初步评估,却无法防止过拟合:如果你反复参照验证期来修改模型,实际上就是在让模型去适应过去。
模拟盘交易(paper trading,即虚拟交易)检验的是:在未来尚未可知时,规律是否依然成立。这是更贴近现实的检验,但资金仍是虚拟的,真实的成交条件也只能部分还原。
真实交易则引入了实际成交价格、流动性和滑点。即使算法本身没有变化,结果也可能改变。
每一个后续阶段都在检验一组新的假设。在前一阶段取得成功,并不能保证在下一阶段同样成功。
研究者发现了什么
作者考察了 32 种方法,涵盖经典机器学习、强化学习、大语言模型(LLM)以及交易智能体。
在 2025 年的历史数据上,24 种 ML 方法中有 23 种取得了正收益。其他类别的方法则没有。
随后,这些方法被选入 2026 年 6 月 4 日至 9 月 21 日的模拟交易阶段,局面随之反转:八种 ML 方法中只有两种保持盈利,而其他类别的六种方法全部以盈利结束了这一时期。
这时很容易得出一个吸引眼球的结论:“经典 ML 输给了 LLM。”但这为时过早。回测期与模拟交易期并不相同,而且进入第二阶段的,都是此前已经表现出色的方法。这样的表格混合了三个因素:市场变化、选择效应和成交条件。
最关键的一点:同一时期内的比较
为了至少排除“市场不同”这一因素,作者在同一区间——2026 年 6 月 4 日至 9 月 21 日——对 14 种方法的回测与模拟交易结果进行了比较。
| 方法 | 回测 | 模拟盘交易 |
|---|---|---|
| XGBoost | +33.95% | +27.53% |
| QWEN | +11.35% | +37.77% |
XGBoost 的模拟交易结果不如回测模拟;QWEN 则恰恰相反,高出 26.42 个百分点。不仅如此,14 种方法中有 10 种在模拟盘交易中的表现高于回测。
这是一个重要的细节:问题并不在于回测总是高估。回测的偏差可能朝两个方向——无论是收益还是风险。
为什么模拟盘交易还不等于真实市场
有四种方法进入了真实资金阶段,测试时间为 2026 年 8 月 24 日至 9 月 21 日。
四种方法中只有一种实现了盈利,而且没有一种跑赢同期简单持有比特币的收益。
成交环节尤其能说明问题:平均价格偏差从模拟交易中的 0.31‰ 上升到真实交易中的 1.86‰,几乎增加到六倍。
不过,结论的适用范围需要把握好。四种方法、四周时间,远不足以宣布整整一类算法不可用。而跑赢比特币也不是普适的标准:不同策略的风险和目标各不相同。
另一个问题:参与者是如何筛选的
如果从一大批算法中只挑选历史上的胜出者进入下一阶段,就会产生偏差风险。其中一些方法获胜,可能并非因为存在稳定的规律,而是得益于某种幸运的市场条件组合。在重新检验时,这种优势可能就此消失。
这个问题早已为人所知。早在 2010 年,Gavin Cawley 和 Nicola Talbot 就在研究 On Over-fitting in Model Selection and Subsequent Selection Bias in Performance Evaluation 中指出:过拟合不仅发生在模型训练过程中,也发生在依据某个指标选择模型的过程中。因此,需要控制的不只是训练,还有挑选胜出者的机制本身。
这与 Tantoryn AI 有什么关系
对我们来说,这是一个实际问题。在 Tantoryn AI 项目中,ML 模型研究、交易候选评估和虚拟交易系统的运行是相互分开的。
在 10 月 5 日至 9 日的报告 中,我们介绍了基于市场状态寻找独立信号的初步结果:若干候选未能通过验证,数据准备中的一个错误被发现并已修正。我们并没有把这些结果当作模型已可用于交易的证据。
当前公开的交易系统运行的是虚拟交易,真实下单处于关闭状态。因此,它的观测结果不能被视为在真实资金上已获证实的收益。反过来也一样:单个研究候选的失败,本身并不能决定整个系统的质量——它们是不同的评估对象。
这项新的外部研究既没有证实、也没有否定 Tantoryn AI 的模型。它由其他作者完成,针对的是其他方法,所处环境也不同。对我们而言,它的价值在于提出了一个更精确的问题:在据此做出更有力的结论之前,每一个后续验证层级究竟需要证明什么?
如何看待关于“成功的交易 AI”的说法
当开发者声称某个模型表现出很高的准确率或盈利时,只看最终数字是不够的。
需要弄清楚:模型和参数是在什么时候选定的,测试结果是否被用于后续修改,最终检验的独立性有多高;条件是否可比——市场时期、成本、成交规则。
最重要的是区分证据的性质。回测、模拟交易和真实交易并不是同一种检验的三个名称。每个阶段都会引入新的假设,也有各自的局限。
一个有力的结果不只是一个很高的指标,而是能够准确说明它证明了什么、在什么条件下获得,以及还有哪些问题悬而未决。
本文讨论的是研究方法论,不构成投资建议,也不包含任何关于 Tantoryn AI 盈利能力的声明。
参考来源
1. Xingtong Yu 等. Can AI Make Money in Crypto? Measuring the Gap from Backtests to Real Markets。2026 年 9 月 28 日。学术预印本。文中数值结果及三个验证阶段描述的主要来源。
2. Gavin Cawley, Nicola Talbot. On Over-fitting in Model Selection and Subsequent Selection Bias in Performance Evaluation。Journal of Machine Learning Research,2010 年。关于模型选择偏差的研究。
3. Tantoryn AI:五天的 ML 研究 —— 错误、检验与首批否定结果。2026 年 10 月 10 日。项目关于其研究工作的官方报告。
4. Tantoryn AI 官方网站。项目及其虚拟交易系统的公开状态。