
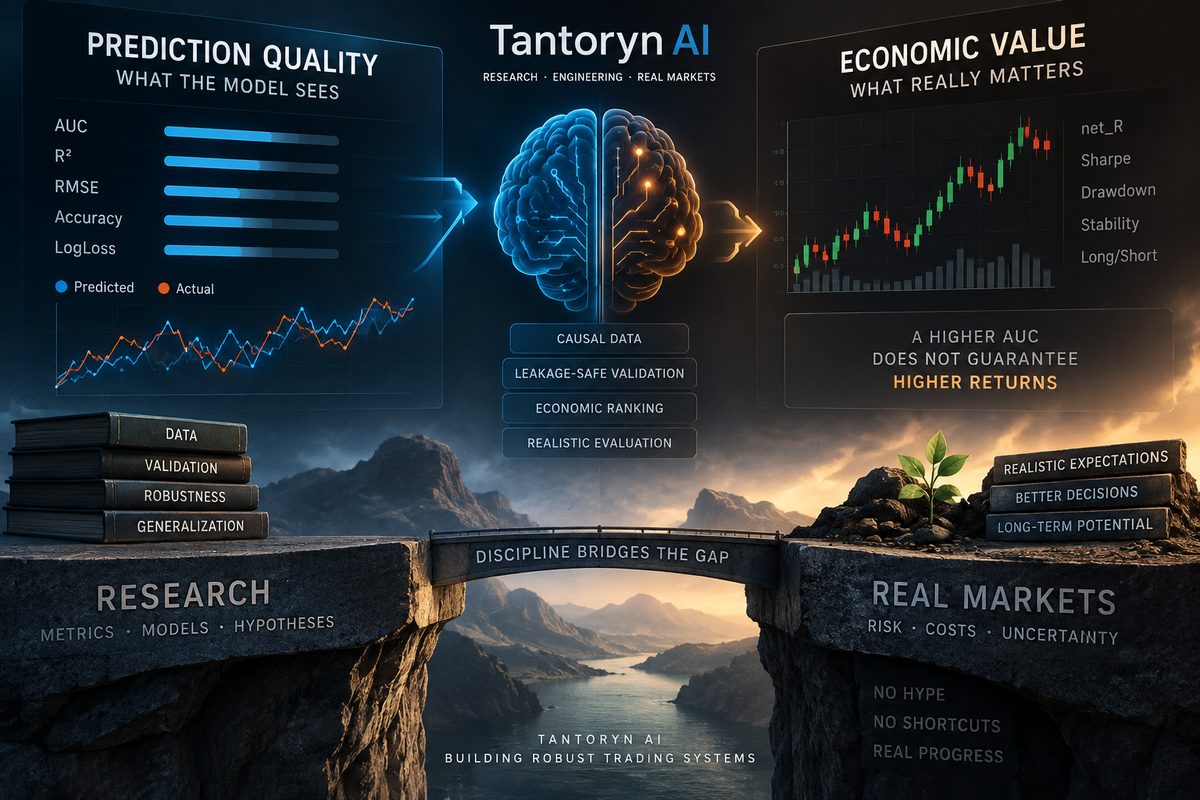
La mayor parte de nuestro trabajo en las últimas dos semanas ocurrió en el lado de machine learning de Tantoryn AI. No solo estábamos midiendo la calidad del modelo — nos hacíamos una pregunta más importante: ¿están los modelos aprendiendo algo genuinamente útil para un sistema de trading?
El primer paso fue completar un nuevo conjunto de datos causalmente correcto para machine learning. Está construido a partir del estado del mercado y no depende de las reglas internas del Candidate Generator. Eso hace que las comparaciones de modelos sean más justas y reduce el riesgo de que un algoritmo capte pistas ocultas, ya sea del futuro o de la propia lógica del sistema de trading.
A continuación, entrenamos y comparamos varias familias diferentes de modelos. Las métricas estándar de ML fueron solo parte del panorama: también verificamos si un buen ranking realmente se traduce en un resultado económicamente útil.
Ahí es donde surgió una limitación importante. Desde el punto de vista del machine learning, los modelos podían mostrar una señal útil, pero eso por sí solo no era suficiente para tratar la configuración actual como económicamente convincente.
En lugar de seguir ajustando umbrales y combinaciones de modelos, detuvimos esa línea de trabajo y volvimos al propio objetivo de aprendizaje.
Tras una etapa dedicada de Rediseño de Objetivo, elegimos una nueva configuración para los modelos Intra: la tarea principal del modelo ahora es estimar qué tan grande es el resultado de un estado de mercado en un horizonte fijo de 12 horas.
En términos simples, el modelo ya no responde a "¿Será rentable esta operación o no?". En cambio, debe responder a "¿Qué tan bueno o malo es el resultado esperado de este estado de mercado?".
Para el diseño actual hemos desactivado la configuración binaria separada de ganancia/pérdida, porque varios modelos distintos expusieron la misma debilidad en esa formulación.
En el camino, examinamos más de cerca dos problemas que importan para cualquier IA de trading.
El primero: una alta precisión del modelo no hace, por sí sola, que un modelo sea útil en el trading real. Explicamos por qué en "Why an “Accurate” AI Trading Model Can Still Be Useless in the Market".
El segundo: un backtest afortunado, o una ejecución sólida de un modelo, no prueba que el modelo sea robusto. Ese es el tema de "Why One Great Backtest Does Not Prove a Trading AI Works".
Aplicamos ambos principios en este ciclo: ejecuciones de entrenamiento repetidas, períodos de validación separados, y ninguna elección de modelo solo porque una ejecución en particular resultó especialmente buena.
El principal resultado de estas dos semanas no es una nueva cifra de rendimiento, ni el anuncio de un "mejor modelo".
Es que encontramos una limitación en el planteamiento anterior del problema antes de llevarlo más lejos dentro del sistema, y la reemplazamos por un objetivo de aprendizaje mejor fundamentado.
El siguiente paso es entrenar modelos bajo la nueva configuración y verificar si una señal económicamente útil se mantiene fuera de los datos usados para el ajuste.