
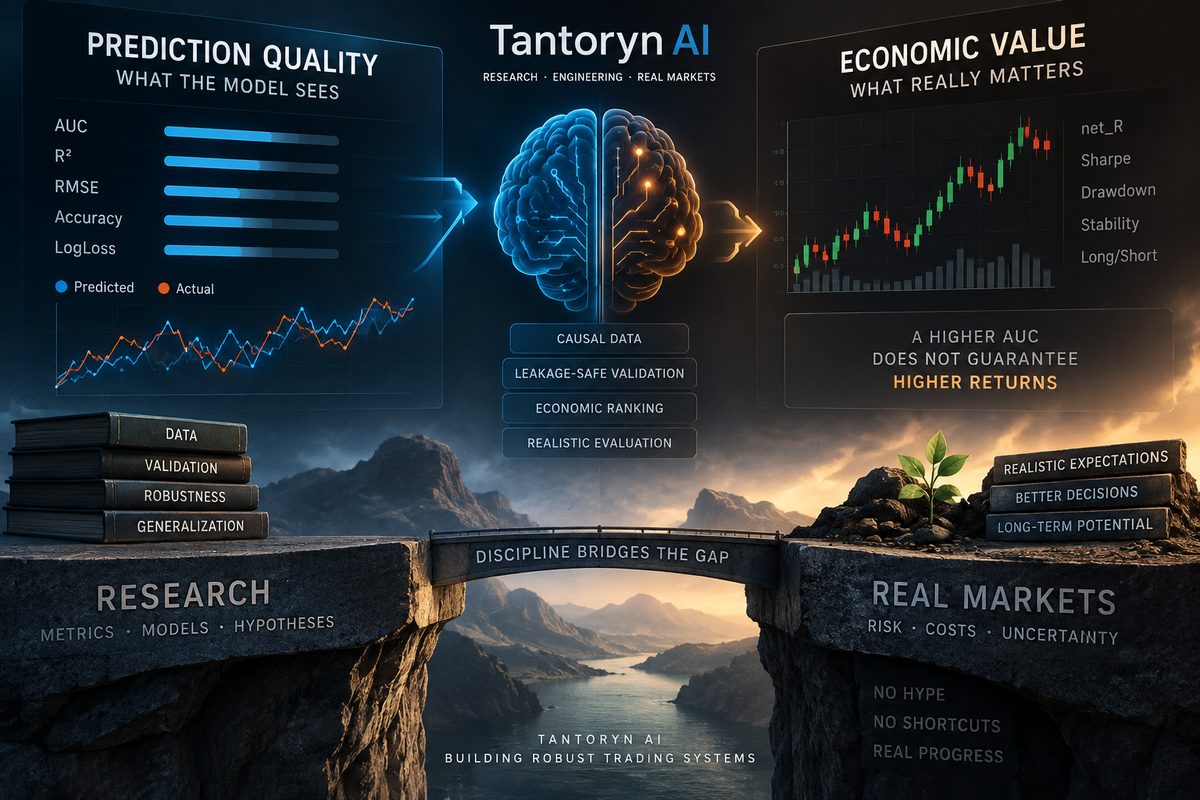
Son iki haftadaki çalışmalarımızın çoğu Tantoryn AI'nin makine öğrenimi tarafında gerçekleşti. Sadece model kalitesini ölçmüyorduk — daha önemli bir soru soruyorduk: modeller bir trading sistemi için gerçekten yararlı olan bir şeyi mi öğreniyor?
İlk adım, makine öğrenimi için nedensel olarak doğru yeni bir veri kümesini tamamlamaktı. Bu veri kümesi piyasanın durumundan oluşturulur ve Candidate Generator'ın iç kurallarına bağlı değildir. Bu, model karşılaştırmalarını daha adil hale getirir ve bir algoritmanın ister gelecekten ister trading sisteminin kendi mantığından gizli ipuçları alma riskini azaltır.
Ardından birkaç farklı model ailesini eğitip karşılaştırdık. Standart ML metrikleri resmin yalnızca bir parçasıydı: iyi sıralamanın gerçekten ekonomik açıdan yararlı bir sonuca dönüşüp dönüşmediğini de kontrol ettik.
Önemli bir sınırlama tam da burada ortaya çıktı. Makine öğrenimi açısından modeller yararlı bir sinyal gösterebiliyordu, ancak bu tek başına mevcut kurulumu ekonomik açıdan ikna edici saymak için yeterli değildi.
Eşik değerlerini ve model kombinasyonlarını ayarlamaya devam etmek yerine, bu çalışma hattını durdurduk ve öğrenme hedefinin kendisine geri döndük.
Özel bir Hedef/Amaç Yeniden Tasarımı aşamasının ardından, Intra modelleri için yeni bir kurulum seçtik: modelin ana görevi artık sabit bir 12 saatlik ufuk boyunca bir piyasa durumunun sonucunun ne kadar büyük olduğunu tahmin etmek.
Basitçe ifade etmek gerekirse, model artık "Bu işlem kârlı olacak mı olmayacak mı?" sorusuna cevap vermiyor. Bunun yerine "Bu piyasa durumunun beklenen sonucu ne kadar iyi ya da kötü?" sorusuna cevap vermesi gerekiyor.
Mevcut tasarım için ayrı ikili kâr/zarar kurulumunu devre dışı bıraktık, çünkü birkaç farklı model bu formülasyondaki aynı zayıflığı ortaya çıkardı.
Bu süreçte, herhangi bir trading yapay zekâsı için önemli olan iki soruna daha yakından baktık.
Birincisi: yüksek model doğruluğu, tek başına bir modeli gerçek trading'de yararlı kılmaz. Bunun nedenini "Why an “Accurate” AI Trading Model Can Still Be Useless in the Market" yazımızda açıklıyoruz.
İkincisi: şanslı bir backtest ya da bir modelin güçlü bir çalıştırması, o modelin dayanıklı olduğunu kanıtlamaz. Bu konu "Why One Great Backtest Does Not Prove a Trading AI Works" yazımızın konusu.
Bu döngüde her iki ilkeyi de uyguladık: tekrarlanan eğitim çalıştırmaları, ayrı doğrulama dönemleri ve bir çalıştırma sadece özellikle iyi göründüğü için bir modeli seçmemek.
Bu iki haftanın ana sonucu yeni bir getiri rakamı değil ve bir "en iyi model" duyurusu da değil.
Sonuç, önceki problem çerçevelemesindeki bir sınırlamayı, onu sistemin geri kalanına taşımadan önce bulmuş ve daha sağlam temellere dayanan bir öğrenme hedefiyle değiştirmiş olmamız.
Bir sonraki adım, modelleri yeni kurulum altında eğitmek ve ekonomik açıdan yararlı bir sinyalin, ayar için kullanılan verilerin dışında da geçerliliğini koruyup korumadığını kontrol etmek.