
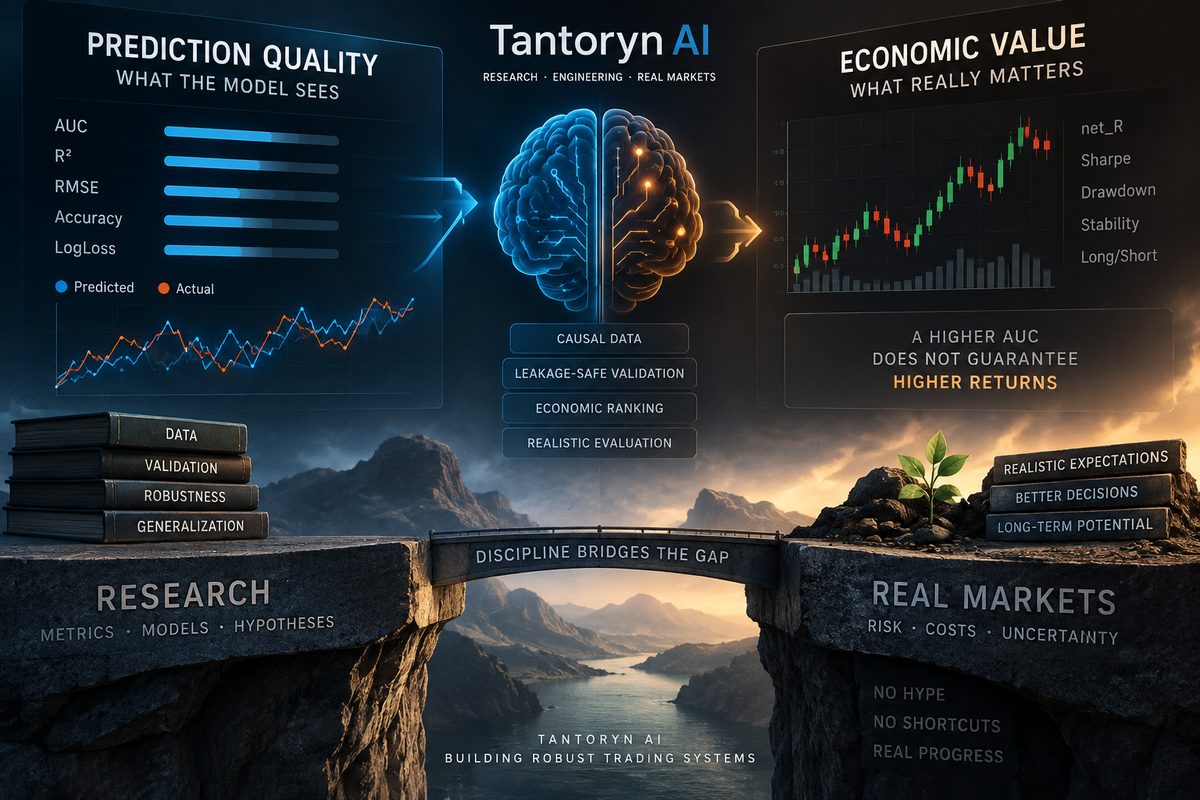
过去两周,我们的大部分工作都集中在 Tantoryn AI 的机器学习方面。我们不只是在衡量模型质量 —— 我们在追问一个更重要的问题:这些模型学到的东西,对交易系统而言是否真正有用?
第一步是完成一个因果关系正确的新机器学习数据集。它基于市场状态构建,不依赖于候选生成器(Candidate Generator)的内部规则。这使得模型比较更加公平,也降低了算法从未来信息或交易系统自身逻辑中获取隐藏线索的风险。
接下来,我们训练并比较了若干不同的模型系列。标准 ML 指标只是全貌的一部分:我们还检查了良好的排序能力是否真的能转化为具有经济价值的结果。
正是在这里,一个重要的局限浮出水面。从机器学习的角度看,这些模型能够显示出有用的信号,但仅凭这一点,不足以将当前的方案视为在经济上具有说服力。
我们没有继续调整阈值和模型组合,而是停下了这条工作线,回到学习目标本身重新思考。
在经过一个专门的目标重新设计阶段后,我们为 Intra 模型选择了一种新的方案:模型的主要任务现在是估算在固定的 12 小时窗口内,某一市场状态的结果有多大。
简单来说,模型不再回答“这笔交易会盈利吗?”,而是必须回答“这一市场状态的预期结果有多好或多差?”
针对当前设计,我们关闭了此前单独的二元盈亏方案,因为多个不同模型都暴露出该表述方式的同一个弱点。
在此过程中,我们进一步深入研究了对任何交易 AI 都很重要的两个问题。
第一个问题:模型准确率高,本身并不意味着它在真实交易中有用。我们在 "Why an “Accurate” AI Trading Model Can Still Be Useless in the Market" 一文中解释了原因。
第二个问题:一次幸运的回测,或模型的一次出色表现,并不能证明该模型是稳健的。这正是 "Why One Great Backtest Does Not Prove a Trading AI Works" 一文所探讨的主题。
在这一周期中,我们将这两条原则都付诸实践:反复进行训练、使用独立的验证周期,并且不会仅因为某一次运行结果格外亮眼就选定某个模型。
过去两周最主要的成果,并非一个新的收益数字,也不是宣布某个“最佳模型”。
真正的成果在于:我们在将此前的问题表述方式进一步带入系统之前,发现了其中的一处局限,并用一个基础更扎实的学习目标取而代之。
下一步是在新方案下训练模型,并检验这一具有经济价值的信号,在用于调参的数据之外是否依然成立。