
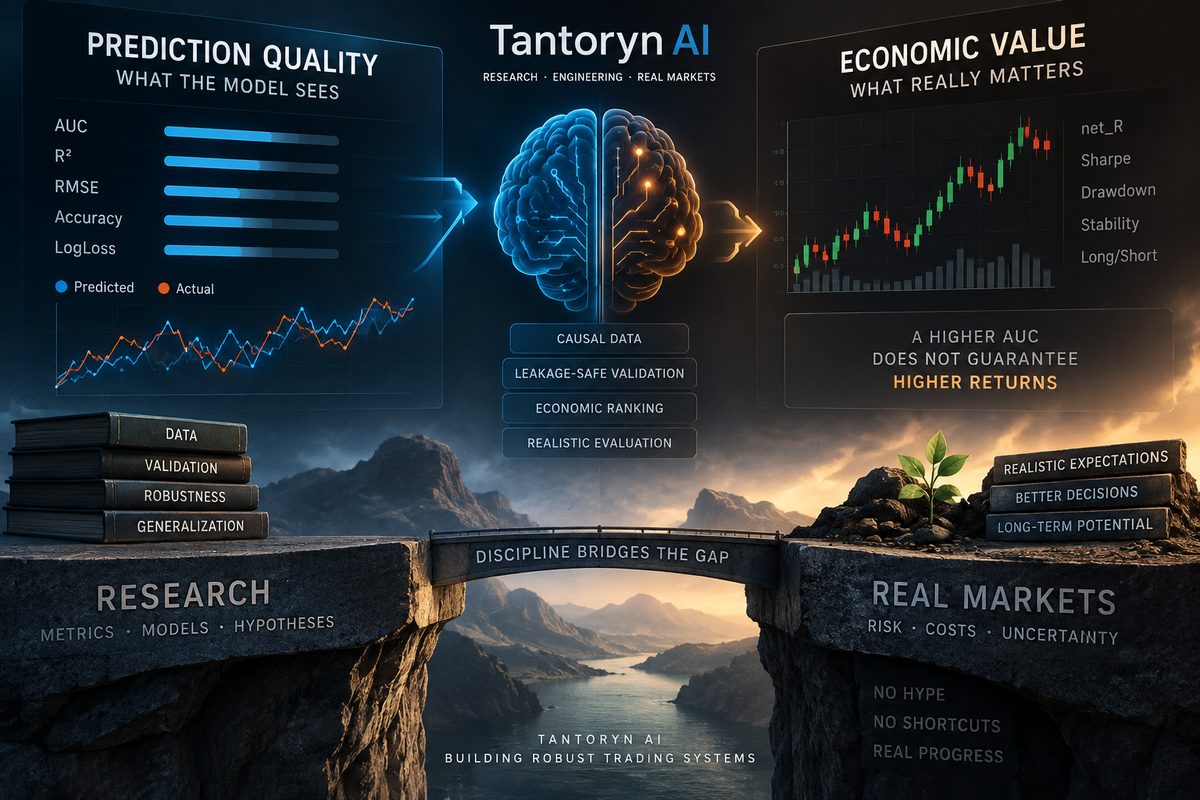
A maior parte do nosso trabalho nas últimas duas semanas aconteceu no lado de machine learning da Tantoryn AI. Não estávamos apenas medindo a qualidade do modelo — estávamos fazendo uma pergunta mais importante: os modelos estão aprendendo algo genuinamente útil para um sistema de trading?
O primeiro passo foi concluir um novo conjunto de dados causalmente correto para machine learning. Ele é construído a partir do estado do mercado e não depende das regras internas do Candidate Generator. Isso torna as comparações de modelos mais justas e reduz o risco de um algoritmo captar pistas ocultas, seja do futuro ou da própria lógica do sistema de trading.
Em seguida, treinamos e comparamos várias famílias diferentes de modelos. As métricas padrão de ML foram apenas parte do quadro: também verificamos se um bom ranqueamento realmente se traduz em um resultado economicamente útil.
Foi aí que surgiu uma limitação importante. Do ponto de vista de machine learning, os modelos podiam mostrar um sinal útil, mas isso sozinho não era suficiente para tratar a configuração atual como economicamente convincente.
Em vez de continuar ajustando limiares e combinações de modelos, interrompemos essa linha de trabalho e voltamos ao próprio objetivo de aprendizado.
Após uma etapa dedicada de Redesenho de Alvo/Objetivo, escolhemos uma nova configuração para os modelos Intra: a principal tarefa do modelo agora é estimar quão grande é o resultado de um estado de mercado em um horizonte fixo de 12 horas.
Em termos simples, o modelo não responde mais a "Esta operação será lucrativa ou não?". Em vez disso, ele deve responder a "Quão bom ou ruim é o resultado esperado deste estado de mercado?".
Para o design atual, desativamos a configuração binária separada de lucro/prejuízo, porque vários modelos diferentes expuseram a mesma fraqueza nessa formulação.
Ao longo do caminho, examinamos mais de perto dois problemas que importam para qualquer IA de trading.
O primeiro: alta acurácia do modelo não torna, por si só, um modelo útil no trading real. Explicamos por quê em "Why an “Accurate” AI Trading Model Can Still Be Useless in the Market".
O segundo: um backtest sortudo, ou uma execução forte de um modelo, não prova que o modelo é robusto. Esse é o tema de "Why One Great Backtest Does Not Prove a Trading AI Works".
Aplicamos ambos os princípios neste ciclo: execuções de treinamento repetidas, períodos de validação separados, e nenhuma escolha de modelo apenas porque uma execução em particular parecia especialmente boa.
O principal resultado dessas duas semanas não é um novo número de retorno, e não é o anúncio de um "melhor modelo".
É que encontramos uma limitação no enquadramento anterior do problema antes de levá-lo adiante no sistema, e a substituímos por um objetivo de aprendizado mais bem fundamentado.
O próximo passo é treinar modelos sob a nova configuração e verificar se um sinal economicamente útil se mantém fora dos dados usados para o ajuste.