
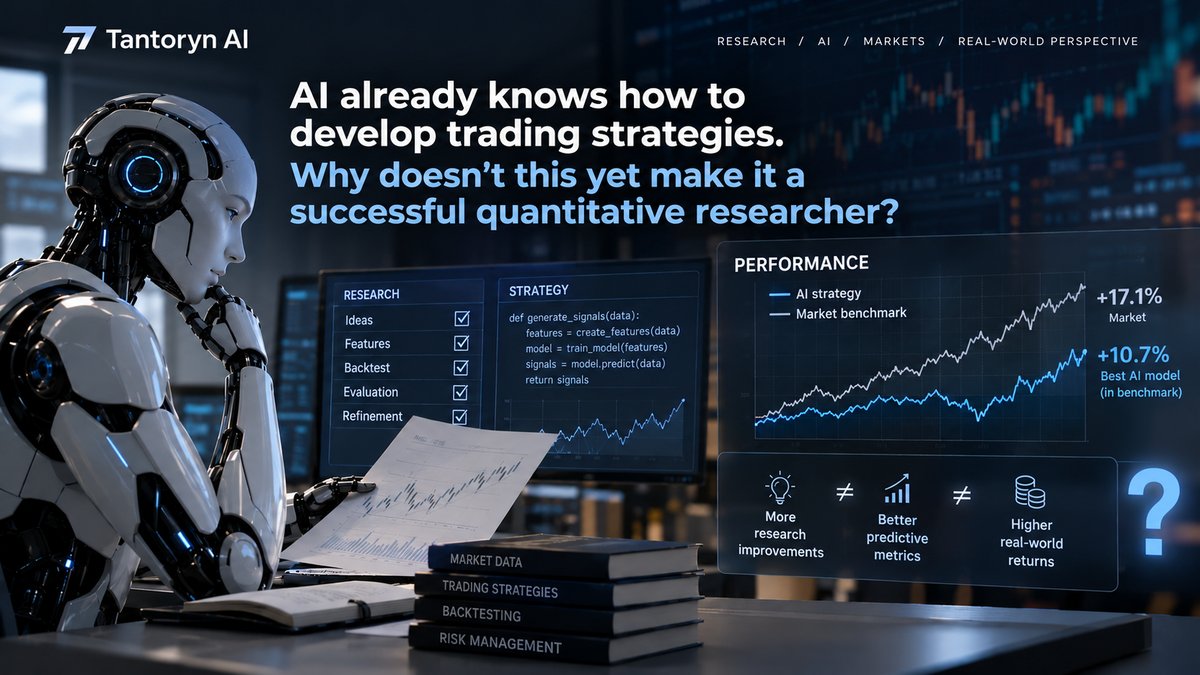
La inteligencia artificial es capaz de crear hipótesis de trading, entrenar modelos y analizar los resultados de los experimentos. Sin embargo, la correcta finalización de un cálculo no significa que se haya descubierto un patrón de mercado útil.
En octubre de 2026, este problema se manifestó en las investigaciones de Tantoryn AI. Estábamos probando nuevos enfoques para encontrar patrones de trading, obtuvimos resultados negativos y descubrimos un error en la preparación de los datos.
Estos hechos importan no porque hayan dado lugar a una nueva estrategia de trading, sino porque mostraron qué resultados no pueden aceptarse sin una verificación adicional.
Qué estábamos investigando
A principios de octubre, el trabajo seguía la línea de ML Setup Discovery. Su objetivo es explorar si el aprendizaje automático puede identificar patrones de trading a partir de descripciones del estado del mercado.
Esta línea se diferencia de las familias de trading deterministas existentes en Tantoryn AI, donde las condiciones para formar candidatos las fijan reglas preestablecidas. ML Setup Discovery investiga una pregunta distinta: ¿puede un modelo descubrir patrones adicionales en estados de mercado históricos?
Para ello no basta con obtener una buena métrica de entrenamiento. Hay que establecer que la dependencia descubierta se mantiene más allá de la muestra de investigación, que no surge de particularidades de la preparación de los datos y que ofrece fundamentos suficientes para su consideración posterior. Los resultados más importantes surgieron precisamente en estas comprobaciones.
Primer resultado: un modelo entrenado aún no significa un patrón descubierto
En los experimentos de octubre, varios candidatos de investigación superaron las etapas prescritas de entrenamiento y validación técnica. Pero la finalización de los cálculos no se convirtió en motivo para aceptarlos.
En unos casos, los resultados no permitían decidir con fundamento cómo utilizar las puntuaciones que producía el modelo. En otros, las evidencias disponibles eran insuficientes para considerar estable el patrón descubierto. Estos candidatos no fueron admitidos para su uso posterior.
Se trata de un resultado de investigación negativo, no de un fallo técnico del entrenamiento. Un modelo puede terminar correctamente su ejecución, producir predicciones y obtener métricas medibles, y aun así no aportar evidencias convincentes de que esas predicciones sean útiles para las decisiones de trading. Esta es la diferencia entre ejecutar con éxito un experimento y confirmar una hipótesis de investigación. Los primeros resultados de estas comprobaciones los describimos en un informe separado.
Para Tantoryn AI esta distinción es fundamental: el simple hecho de que un modelo haya sido entrenado no es base suficiente para cambiar el sistema de trading.
Segundo problema: comprobaciones que concluían sin datos utilizables
El problema técnico más importante apareció en la preparación de los datos. Algunas comprobaciones concluían formalmente con éxito, aunque los datos preparados para la evaluación correspondiente no contenían observaciones utilizables.
Esto significaba que un estado técnico de éxito no podía interpretarse como confirmación de la calidad del modelo. El programa comunicaba una comprobación finalizada, pero no existía base real para una conclusión de investigación positiva.
El error no era que el modelo hubiera dado un resultado débil, sino que una comprobación podía concluir sin datos suficientes para evaluarlo. Tras descubrir el problema, hubo que corregir la preparación de los datos y volver a verificar los resultados correspondientes.
Este caso reveló un requisito importante para la infraestructura de investigación. No basta con comprobar únicamente la ausencia de errores de software. También hay que establecer por separado que los datos preparados contienen realmente observaciones utilizables; que la comprobación se ejecutó en la muestra prevista; que las métricas obtenidas tienen un significado definido; y que la finalización de un procedimiento no sustituye a la confirmación de un resultado de investigación. De lo contrario, la automatización crea una falsa sensación de fiabilidad.
Por qué las buenas métricas de investigación pueden inducir a error
Un problema similar se examina en el estudio Quant-Arena: Benchmarking LLM Agents for Quantitative Trading Research, publicado el 21 de octubre. Sus autores pusieron a prueba nueve modelos de lenguaje capaces de desarrollar y mejorar estrategias de trading cuantitativas por sí mismos en el mercado de acciones.
Cuando los modelos pudieron corregir sus soluciones paso a paso, la puntuación media de investigación subió. Sin embargo, el resultado financiero mejoró solo en cuatro de los nueve modelos — y empeoró en los otros cinco. En otras palabras: un proceso de investigación más exitoso no conducía necesariamente a una estrategia más eficaz.
Una discusión ampliada de este experimento se está preparando para su publicación en HackerNoon.
Es importante no confundir los dos estudios. Quant-Arena examina la capacidad de los modelos de lenguaje para realizar investigaciones cuantitativas por su cuenta en el mercado de acciones. Nuestros experimentos de octubre se refieren al ML Setup Discovery en Tantoryn AI. Se diferencian en la formulación del problema, los métodos y los procedimientos de evaluación. El problema común está en otro lugar: unas métricas de investigación elevadas y experimentos técnicamente concluidos no son prueba suficiente del valor económico de un modelo.
Por qué mantenemos separadas la investigación, la evaluación y la gestión de riesgos
En Tantoryn AI, la búsqueda de patrones de trading, la validación de los candidatos de investigación y la gestión de riesgos se tratan como tareas diferentes. Un resultado de investigación debe superar la evaluación prescrita antes de que existan fundamentos para hablar de su uso posterior.
Esto es especialmente importante en el aprendizaje automático. Un modelo puede detectar una dependencia estadística que desaparece cuando cambian las condiciones del mercado. Puede funcionar bien en el periodo de investigación pero no mantener la calidad en datos independientes. Y, por último, incluso una predicción correcta no garantiza una ventaja económica una vez consideradas las restricciones de trading.
Por eso no consideramos el número de modelos entrenados o de experimentos completados como una métrica de progreso por sí sola. Un resultado negativo también puede ser útil si se obtiene correctamente y permite descartar una decisión injustificada.
El actual circuito público de trading de Tantoryn AI opera con operaciones virtuales. La ejecución de órdenes reales está desactivada. Los resultados de la investigación y del trading virtual no son prueba de rentabilidad con capital real.
Qué cambió en nuestra comprensión del proceso de investigación
Los experimentos de octubre nos permitieron precisar dos requisitos prácticos.
Primero: toda conclusión positiva de investigación debe apoyarse en datos verificables. La mera finalización formal de un procedimiento no es suficiente. Hay que confirmar que la evaluación tuvo lugar realmente y que su resultado puede interpretarse.
Segundo: un candidato de investigación debe aportar evidencias acordes con el uso previsto. Una buena métrica de entrenamiento no sustituye la comprobación de la estabilidad y del sentido económico del resultado. Estos requisitos no garantizan que los modelos futuros tengan éxito, pero reducen el riesgo de tomar decisiones basadas en evidencias poco fiables o insuficientes.
Conclusión
En octubre, Tantoryn AI no obtuvo fundamentos para declarar que los candidatos investigados de ML Setup Discovery eran nuevas estrategias de trading confirmadas. En su lugar, obtuvimos dos resultados de importancia práctica. El primero: la confirmación de que un modelo correctamente entrenado puede carecer de evidencias suficientes de utilidad. El segundo: el descubrimiento de un error de preparación de datos en el que una comprobación técnicamente concluida no equivalía a una evaluación real.
Estos resultados son coherentes con el problema más amplio que demuestra Quant-Arena: la automatización de la investigación avanza más rápido que nuestra capacidad de confirmar de forma fiable su valor económico. Para nosotros, desarrollar IA de trading no consiste solo en buscar nuevos patrones, sino también en saber rechazar a tiempo los resultados que aún no merecen confianza.
Este material refleja la actividad investigadora de Tantoryn AI. Los resultados descritos no son prueba de la rentabilidad del sistema de trading ni constituyen una recomendación de inversión.
Fuentes y materiales relacionados
1. Houde Qian et al. Quant-Arena: Benchmarking LLM Agents for Quantitative Trading Research. 21 de octubre de 2026. El estudio principal.
2. Quant-Arena — página oficial del proyecto. Descripción del entorno experimental y de los resultados.
3. Sichun Luo et al. AlphaQT-Bench: Diagnosing the Gap between Financial Code Generation and Quantitative Reasoning in LLMs. Findings of ACL 2026. Un estudio sobre la distancia entre el código ejecutable y los cálculos financieros correctos.