
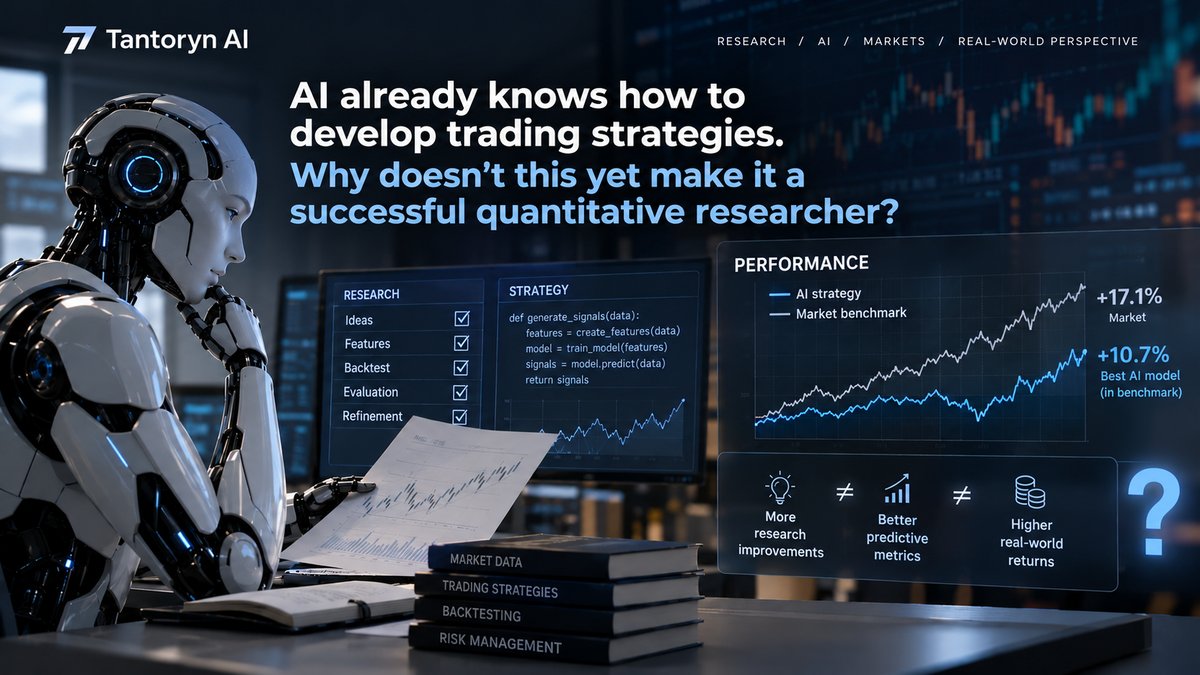
人工智能能够构建交易假设、训练模型并分析实验结果。然而,计算的成功完成并不意味着发现了有用的市场规律。
2026 年 10 月,这个问题在 Tantoryn AI 自己的研究中显现出来。当时我们正在检验寻找交易规律的新方法,得到了否定结果,并发现了数据准备中的一处错误。
这些事件之所以重要,不是因为它们带来了新的交易策略,而是因为它们表明:哪些结果如果没有额外的验证,就不能被采纳。
我们在研究什么
10 月初,工作集中在 ML Setup Discovery 方向。它的目标是探索:机器学习能否基于对市场状态的描述来识别交易规律。
这一方向不同于 Tantoryn AI 现有的确定性交易家族——在那些家族中,候选信号的形成条件由预先设定的规则决定。ML Setup Discovery 研究的是另一个问题:模型能否在历史市场状态中发现额外的规律。
要做到这一点,仅仅取得良好的训练指标是不够的。还必须确立:所发现的依赖关系在研究样本之外仍然成立;它不是数据准备中的特殊产物;并且它有充分的依据进入后续考量。最重要的结果恰恰出现在这些检验之中。
第一个结果:训练完成的模型还不等于发现了规律
在 10 月的实验中,若干研究候选通过了既定的训练与技术验证阶段。但计算的完成并没有成为采纳它们的理由。
在某些情况下,结果无法为“如何使用模型产生的评分”提供有依据的判定;在另一些情况下,现有证据不足以认定所发现的规律是稳定的。这类候选未获准入,不得进入后续使用。
这是一个研究上的否定结果,而不是训练的技术故障。模型可以正确地完成运行、生成预测并获得可测量的指标,却仍无法提供有说服力的证据,证明这些预测对交易决策有用。成功执行实验与证实研究假设之间的区别正在于此。这些检验的初步结果,我们在另一篇报告中已作描述。
对 Tantoryn AI 而言,这一区别是原则性的:模型完成训练这一事实本身,并不构成改变交易系统的充分依据。
第二个问题:在没有可用数据的情况下完成的检验
更重要的技术问题出现在数据准备环节。一部分检验在形式上成功结束,尽管为相应评估准备的数据并不包含可用的观测。
这意味着,成功的技术状态不能被解读为对模型质量的确认。程序报告检验已完成,但实际上并不存在支持正面研究结论的基础。
错误不在于模型给出了薄弱的结果,而在于检验可能在缺少足够评估数据的情况下结束。问题发现之后,必须修正数据准备,并重新验证相应的结果。
这一案例揭示了研究基础设施的一项重要要求。仅检查是否存在程序错误是不够的。还必须单独确认:准备好的数据确实包含可用的观测;检验是在预定的样本上执行的;所得的指标具有明确的含义;以及程序的完成不能替代研究结果的确认。否则,自动化会制造一种虚假的可靠感。
为什么良好的研究指标可能具有误导性
类似的问题在 10 月 21 日发表的研究 Quant-Arena: Benchmarking LLM Agents for Quantitative Trading Research 中得到了审视。它的作者检验了九个语言模型,这些模型能够在股票市场上独立开发和改进量化交易策略。
当模型被允许逐步修正自己的方案时,平均研究得分上升了。然而,财务结果只有在九个模型中的四个身上有所改善——在其余五个模型身上反而恶化了。换言之,更成功的研究过程并不必然带来更有效的策略。
关于这一实验的更深入的讨论正在准备中,届时将发表于 HackerNoon。
重要的是不要把两项研究混为一谈。Quant-Arena 研究的是语言模型在股票市场上独立开展量化研究的能力;而我们 10 月的实验关注的是 Tantoryn AI 的 ML Setup Discovery。两者在问题设定、方法和评估程序上都不同。共同的问题在别处:高昂的研究指标和技术上完成的实验,并不足以构成模型经济价值的证明。
为什么我们把研究、评估与风险管理分开
在 Tantoryn AI,寻找交易规律、验证研究候选和风险管理被视为不同的任务。研究结果必须通过既定的评估,然后才有依据讨论它的进一步使用。
这一点在机器学习中尤为重要。模型可能发现一种统计依赖关系,而它会在市场条件变化时消失;模型可能在研究期内表现良好,却无法在独立数据上保持质量;最后,即使预测正确,在计入交易约束之后也不能保证经济优势。
因此,我们不把训练出的模型数量或完成的实验数量当作独立的进展指标。否定结果如果获取方式正确,并能排除一个没有依据的决定,同样可以是有价值的。
Tantoryn AI 当前的公开交易回路使用虚拟交易,真实订单的执行处于关闭状态。研究与虚拟交易的结果,不构成对真实资本盈利能力的证明。
我们对研究过程的理解发生了什么变化
10 月的实验使我们得以明确两项实践要求。
第一:每一个正面的研究结论都必须建立在可验证的数据之上。程序的正式完成是不够的。必须确认评估确实发生,且其结果可以被解释。
第二:研究候选必须拥有与其预期用途相匹配的证据。良好的训练指标不能替代对结果稳定性和经济意义的检验。这些要求并不能保证未来的模型会成功,但它们能降低在不可靠或证据不足的情况下做出决策的风险。
结论
10 月,Tantoryn AI 没有获得任何依据,可以把所研究的 ML Setup Discovery 候选宣布为新的、已确认的交易策略。取而代之的是两项具有实践重要性的结果。第一项,是再次确认:成功完成训练的模型可能缺乏关于其有用性的充分证据。第二项,是发现了一处数据准备错误——在这种错误下,技术上完成的检验并不等于一次真正的评估。
这些结果与 Quant-Arena 所展示的更广泛的问题是一致的:研究自动化的发展速度,超过了我们可靠确认其经济价值的能力。对我们来说,交易 AI 的发展不仅在于发现新的规律,也在于能够及时拒绝那些尚不可信的结果。
本文反映的是 Tantoryn AI 的研究工作。所述结果不构成交易系统盈利能力的证明,也不构成投资建议。
来源与相关材料
1. Houde Qian 等. Quant-Arena: Benchmarking LLM Agents for Quantitative Trading Research。2026 年 10 月 21 日。主要研究。
2. Quant-Arena —— 项目官方页面。实验环境与结果的说明。
3. Sichun Luo 等. AlphaQT-Bench: Diagnosing the Gap between Financial Code Generation and Quantitative Reasoning in LLMs。Findings of ACL 2026。关于可执行代码与正确金融计算之间差距的研究。