
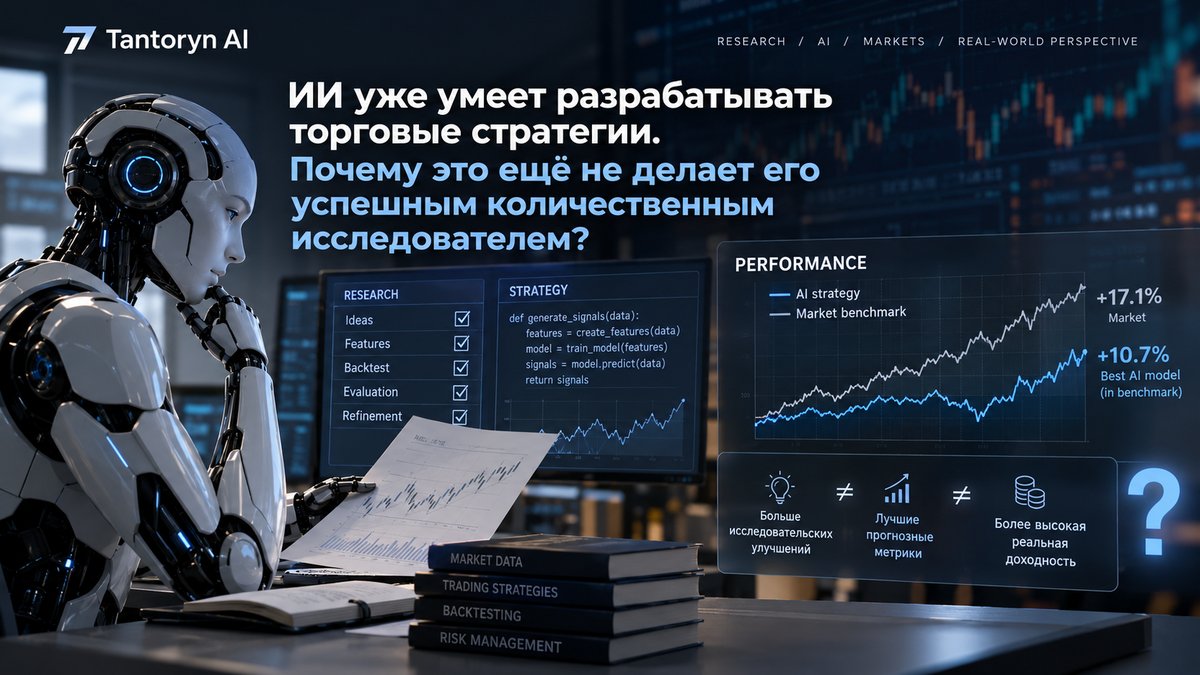
Sun'iy intellekt savdo gipotezalarini yaratishi, modellarni o'qitishi va tajriba natijalarini tahlil qilishi mumkin. Ammo hisoblashlarning muvaffaqiyatli yakunlanishi hali foydali bozor qonuniyatining kashf etilganini anglatmaydi.
2026-yil oktyabrida bu muammo Tantoryn AI tadqiqotlarida namoyon bo'ldi. Biz savdo qonuniyatlarini izlashning yangi yo'nalishlarini tekshirdik, salbiy natijalar oldik va ma'lumotlarni tayyorlashda xato aniqladik.
Bu voqealar yangi savdo strategiyasiga olib kelgani uchun emas, balki qanday natijalarni qo'shimcha tekshiruvsiz qabul qilib bo'lmasligini ko'rsatgani uchun muhim.
Nimani tadqiq qildik
Oktyabr boshida ish ML Setup Discovery yo'nalishida olib borildi. Uning vazifasi — mashinaviy o'qitish yordamida bozor holatining tavsiflaridan savdo qonuniyatlarini aniqlash imkoniyatini o'rganish.
Bu yo'nalish Tantoryn AI ning mavjud deterministik savdo oilalaridan farq qiladi, unda nomzodlarni shakllantirish shartlari oldindan belgilangan qoidalar bilan qat'iy belgilanadi. ML Setup Discovery boshqacha savolni o'rganadi: model tarixiy bozor holatlarida qo'shimcha qonuniyatlarni kasha etishi mumkinmi?
Buning uchun yaxshi o'qitish metrikasini olish yetarli emas. Kashf etilgan bog'liqlik tadqiqot namunasidan tashqarida ham saqlanishi, ma'lumotlarni tayyorlashning xususiyatlaridan kelib chiqmasligi va keyingroq ko'rib chiqish uchun yetarli asoslarga ega ekani aniqlanishi kerak. Eng muhim natijalar aynan shu tekshiruvlarda paydo bo'ldi.
Birinchi natija: o'qitilgan model hali topilgan qonuniyatni anglatmaydi
Oktyabr tajribalari davomida bir nechta tadqiqot nomzodlari belgilangan o'qitish va texnik tekshiruv bosqichlaridan o'tdi. Lekin hisoblashlarning yakunlanishi ularni qabul qilish asosi bo'lmadi.
Bir hollarda natijalar model hosil qilgan baholardan qanday foydalanishni asoslangan tarzda belgilashga imkon bermadi. Boshqa hollarda kashf etilgan qonuniyatni barqaror hisoblash uchun mavjud dalillar yetarli emas edi. Bunday nomzodlar keyingi qo'llanishga kiritilmadi.
Bu texnik o'qitish xatosi emas, balki salbiy tadqiqot natijasidir. Model to'g'ri ishini yakunlashi, prognozlarni shakllantirishi va o'lchanadigan ko'rsatkichlarni olishi mumkin, lekin bu prognozlarning savdo qarorlari uchun foydaligini isbotlashga ishontiruvchi dalillarni taqdim etmasligi mumkin. Muvaffaqiyatli tajriba bajarish va tadqiqot gipotezasini tasdiqlash orasidagi farq shundadir. Bunday tekshiruvlarning ilk natijalarini alohida hisobotda ta'riflab berganmiz.
Tantoryn AI uchun bu farq tamoyiliy ahamiyatga ega: model o'qitilgani faktining o'zi savdo tizimini o'zgartirish uchun yetarli asos hisoblanmaydi.
Ikkinchi muammo: tekshiruvlar foydalanishga yaroqli ma'lumotlarsiz yakunlanardi
Ancha sezilarli texnik muammo ma'lumotlarni tayyorlashda aniqlab olindi. Ayrim tekshiruvlar rasmiy ravishda muvaffaqiyatli yakunlanardi, garchi tegishli baholash uchun tayyorlangan ma'lumotlarda foydalanishga yaroqli kuzatishlar bo'lmasa ham.
Bu muvaffaqiyatli texnik holatni model sifatining tasdig'i sifatida talqin qilib bo'lmasligini anglatardi. Dastur tekshiruv yakunlandi deb xabar berardi, lekin ijobiy tadqiqot xulosasi uchun haqiqiy asos mavjud bo'lmas edi.
Xato modelning zaif natija ko'rsatishida emas edi — tekshiruv uni baholash uchun yetarli ma'lumotlarsiz yakunlanishi mumkin edi. Muammo aniqlangach, ma'lumotlarni tayyorlashni tuzatish va tegishli natijalarni qayta tekshirish talab etildi.
Bu hol tadqiqot infratuzilmasiga muhim talabni yuzaga chiqardi. Faqat dasturiy xatolarning mavjud emasligini nazorat qilish yetarli emas. Bundan tashqari alohida aniqlanishi kerak: tayyorlangan ma'lumotlarda haqiqatan foydalanishga yaroqli kuzatishlar borligi; tekshiruv ko'zda tutilgan namunada o'tkazilgani; olingan ko'rsatkichlar aniq ma'noga ega ekani; va jarayonning yakunlanishi tadqiqot natijasining tasdig'ini almashtirmasligi. Aks holda avtomatizatsiya ishonchlilikning soxta tuyg'usini yaratadi.
Yaxshi tadqiqot metrikalari nega chalg'itishi mumkin
Shunga o'xshash muammo 21-oktabrda e'lon qilingan Quant-Arena: Benchmarking LLM Agents for Quantitative Trading Research tadqiqotida ko'rib chiqiladi. Uning mualliflari fond bozorida mustaqil ravishda kvant savdo strategiyalarini ishlab chiqish va takomillashtirishga qodir bo'lgan to'qqizta til modelini sinab ko'rishdi.
Modellarga yechimlarini bosqichma-bosqich tuzatishga ruxsat berilganda, o'rtacha tadqiqot bahosi oshdi. Lekin moliyaviy natija to'qqiz modeldan faqat to'rttasida yaxshilandi. Qolgan beshitasida esa yomonlashdi. Boshqa so'zlab aytganda, muvaffaqiyatliroq tadqiqot jarayoni zo'riroq strategiyaga olib kelmasligi mumkin edi.
Biz bu tajribani alohida maqolada batafsil tahlil qildik: «Sun'iy intellekt savdo strategiyalarini yaratishni o'rgandi. Lekin daromad qilishni o'rgandimi?» — Tantoryn AI ning Dzendagi maqolasi.
Ikki turli tadqiqotni aralashtirmaslik muhim. Quant-Arena til modellarining fond bozorida mustaqil kvant tadqiqot o'tkazish qobiliyatini o'rganadi. Bizning oktyabr tajribalarimiz esa Tantoryn AI dagi ML Setup Discovery ga oid edi. Ular masala qo'yilishi, usullar va baholash protseduralari bo'yicha farq qiladi. Umumiy muommo boshqa joyda: yuqori tadqiqot ko'rsatkichlari va texnik jihatdan yakunlangan tajribalar modelning iqtisodiy qadrining yetarli isboti emas.
Nega tadqiqot, baholash va risklarni boshqarishni bir-biridan ajratamiz
Tantoryn AI da savdo qonuniyatlarini izlash, tadqiqot nomzodlarini tekshirish va risklarni boshqarish turli vazifalar sifatida qaraladi. Tadqiqot natijasi keyingi qo'llanishini muhokama qilish asosi paydo bo'lishidan oldin belgilangan baholanishdan o'tishi kerak.
Bu mashinaviy o'qitish bilan ishlashda alohida muhim. Model bozor sharoitlari o'zgarganda yo'qoladigan statistik bog'liqlikni aniqlashi mumkin. U tadqiqot davrida yaxshi ishlashi mumkin, lekin mustaqil ma'lumotlarda sifatni saqlab qolmasligi mumkin. Nihoyat, hatto to'g'ri prognoz ham savdo cheklovlarini hisobga olgandan keyin iqtisodiy ustunlikni kafolatlamaydi.
Shu bois biz o'qitilgan modellar soni yoki yakunlangan tajribalar sonini o'z-o'zidan taraqqiyot ko'rsatkichi deb qabul qilmaymiz. To'g'ri olingan salbiy natija ham foydali bo'lishi mumkin, agar u asoslanmagan qarorni istisno qilishga yordam bersa.
Shu bilan birga, Tantoryn AI ning joriy ommaviy savdo konturi virtual bitimlardan foydalanadi. Real orderlarning ijrosi o'chirilgan. Tadqiqot va virtual savdo natijalari real kapitalda foydalilikning isboti emas.
Tadqiqot jarayonini tushunishda nima o'zgardi
Oktyabr tajribalari ikkita amaliy talabni aniqlashtirish imkonini berdi.
Birinchidan: har bir ijobiy tadqiqot xulosasi tekshiriladigan ma'lumotlarga tayanishi kerak. Jarayonning rasmiy yakunlanishi yetarli emas. Baholash haqiqatan bo'lib o'tgani va uning natijasini talqin qilish mumkinligi isbotlanishi zarur.
Ikkinchidan: tadqiqot nomzodi taxmin qilinadigan qo'llanishga mos dalillarga ega bo'lishi kerak. Yaxshi o'qitish metrikasi barqarorlik va natijaning iqtisodiy ma'nosini tekshirishning o'rnini bosmaydi. Bu talablar kelajakdagi modellar muvaffaqiyatiga kafolat bermaydi, ammo ishonchsiz yoki yetarli emas dalillarga tayanib qaror qabul qilish xavfini kamaytiradi.
Xulosa
Oktyabrda Tantoryn AI tadqiq qilingan ML Setup Discovery nomzodlarini yangi, tasdiqlangan savdo strategiyalari deb e'lon qilish uchun hech qanday asos olmadi. Buning o'rniga ikki amaliy jihatdan muhim natijaga erishdik. Birinchisi — muvaffaqiyatli o'qitilgan model foydalilikning yetarli isbotiga ega bo'lmasligi mumkinligining tasdig'i. Ikkinchisi — texnik jihatdan yakunlangan tekshiruv haqiqiy baholashni ta'minlamaydigan ma'lumotlarni tayyorlash xatosining aniqlanishi.
Bu natijalar Quant-Arena ko'rsatib turgan kengroq muammo bilan uyg'un: tadqiqotlarni avtomatlashtirish ularning iqtisodiy qiymatini ishonchli tasdiqlash qobiliyatidan tezroq rivojlanmoqda. Biz uchun savdo sun'iy intellektini rivojlantirish nafaqat yangi qonuniyatlarni topishda, balki hali ishonib bo'lmas natijalarni o'z vaqtida rad etish qobiliyatidadir.
Materjal Tantoryn AI ning tadqiqot faoliyatini aks ettiradi. Ta'riflangan natijalar savdo tizimining foydaliligini isbot yoki investitsiya tavsiyasi emas.
Manbalar va bog'liq materiallar
1. Houde Qian va hammualliflar. Quant-Arena: Benchmarking LLM Agents for Quantitative Trading Research. 2026-yil 21-oktabr. Asosiy tadqiqot.
2. Quant-Arena — loyihaning rasmiy sahifasi. Eksperimental muhit va natijalar ta'rifi.
3. «Sun'iy intellekt savdo strategiyalarini yaratishni o'rgandi. Lekin daromad qilishni o'rgandimi?» — Tantoryn AI ning Dzendagi maqolasi, 2026-yil 31-oktabr.
4. Sichun Luo va hammualliflar. AlphaQT-Bench: Diagnosing the Gap between Financial Code Generation and Quantitative Reasoning in LLMs. Findings of ACL 2026. Ijro etiladigan kod va to'g'ri moliyaviy hisoblashlar orasidagi farq haqidagi tadqiqot.