
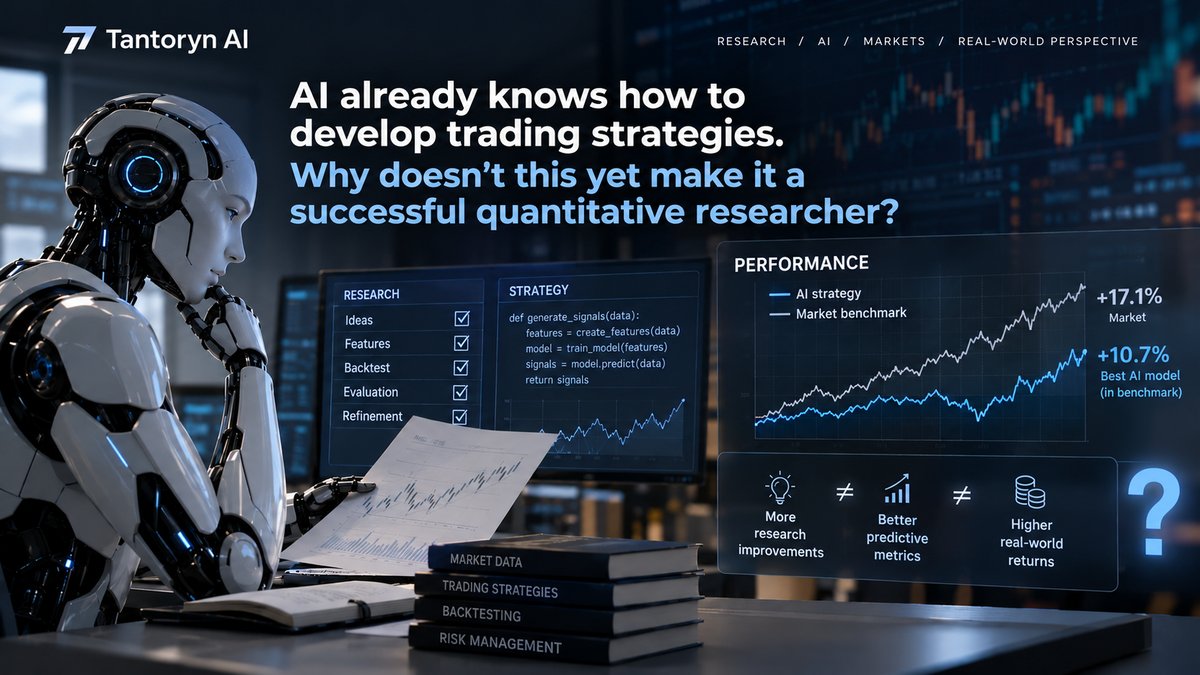
Yapay zekâ, alım-satım hipotezleri oluşturabilir, model eğitebilir ve deney sonuçlarını analiz edebilir. Ne var ki hesaplamaların başarıyla tamamlanması, yararlı bir piyasa örüntüsünün keşfedildiği anlamına gelmez.
Ekim 2026'da bu sorun Tantoryn AI'ın kendi araştırmalarında kendini gösterdi. Alım-satım örüntüleri bulmaya yönelik yeni yaklaşımları test ediyorduk; olumsuz sonuçlar elde ettik ve veri hazırlığında bir hata keşfettik.
Bu gelişmeler, yeni bir alım-satım stratejisine yol açtıkları için değil, hangi sonuçların ek doğrulama olmadan kabul edilemeyeceğini gösterdikleri için önemli.
Neyi araştırıyorduk
Ekim başında çalışma ML Setup Discovery yönünde ilerliyordu. Amacı, makine öğrenmesinin piyasa durumuna ilişkin betimlemelerden alım-satım örüntüleri tanımlayıp tanımlayamayacağını araştırmak.
Bu yön, aday oluşturma koşullarının önceden belirlenmiş kurallarla tanımlandığı Tantoryn AI'ın mevcut deterministik alım-satım ailelerinden farklıdır. ML Setup Discovery başka bir soruyu inceler: bir model, geçmiş piyasa durumlarında ek örüntüler keşfedebilir mi?
Bunun için iyi bir eğitim metriği yetmez. Keşfedilen bağımlılığın araştırma örnekleminin ötesinde sürdüğü, veri hazırlığının özelliklerinden kaynaklanmadığı ve ileride göz önünde bulundurulmak için yeterli gerekçeye sahip olduğu kanıtlanmalıdır. En önemli sonuçlar tam da bu doğrulamalarda ortaya çıktı.
İlk sonuç: eğitilmiş bir model henüz keşfedilmiş bir örüntü anlamına gelmez
Ekim deneyleri sırasında birkaç araştırma adayı, öngörülen eğitim ve teknik doğrulama aşamalarından geçti. Ancak hesaplamaların tamamlanması onları kabul gerekçesi olmadı.
Bazı durumlarda sonuçlar, modelin ürettiği skorların nasıl kullanılacağına ilişkin gerekçeli bir karar vermeye imkân tanımıyordu. Başka durumlarda ise keşfedilen örüntünün kararlı sayılması için mevcut kanıtlar yetersizdi. Bu adaylar ileriki kullanıma kabul edilmedi.
Bu bir teknik eğitim arızası değil, olumsuz bir araştırma sonucudur. Bir model çalışmasını doğru biçimde tamamlayabilir, tahminler üretebilir ve ölçülebilir metrikler elde edebilir; yine de bu tahminlerin alım-satım kararları için yararlı olduğuna dair ikna edici kanıt sunamayabilir. Başarılı bir deney yürütmek ile bir araştırma hipotezini doğrulamak arasındaki fark budur. Bu doğrulamaların ilk sonuçlarını ayrı bir raporda anlattık.
Tantoryn AI için bu ayrım temeldir: bir modelin eğitilmiş olmasının tek başına, alım-satım sistemini değiştirmek için yeterli gerekçe olmadığıdır.
İkinci sorun: kullanılabilir veri olmadan tamamlanan doğrulamalar
Daha önemli teknik sorun veri hazırlığında ortaya çıktı. Bazı doğrulamalar, ilgili değerlendirme için hazırlanan veriler kullanılabilir gözlem içermese de biçimsel olarak başarıyla tamamlanıyordu.
Bu, başarılı teknik durumun model kalitesinin onayı olarak yorumlanamayacağı anlamına geliyordu. Program doğrulamanın tamamlandığını bildiriyor, ancak olumlu bir araştırma sonucuna ilişkin gerçek bir zemin mevcut değildi.
Hata, modelin zayıf bir sonuç göstermesinde değildi — bir doğrulamanın, sonucu değerlendirmeye yetecek veri olmadan tamamlanabilmesindeydi. Sorun keşfedildikten sonra veri hazırlığı düzeltilmek ve ilgili sonuçlar yeniden doğrulanmak zorunda kaldı.
Bu olay, araştırma altyapısı için önemli bir gerekliliği ortaya koydu. Yalnızca yazılım hatalarının bulunmadığını denetlemek yetmez. Ayrıca şunlar ayrı ayrı kanıtlanmalıdır: hazırlanan veriler gerçekten kullanılabilir gözlem içeriyor; doğrulama öngörülen örneklemde çalıştı; elde edilen metrikler belirli bir anlama sahip; ve bir yordamın tamamlanması, araştırma sonucunun onayının yerine geçmiyor. Aksi hâlde otomasyon yanlış bir güvenilirlik hissi yaratır.
İyi araştırma metrikleri neden yanıltabilir
Benzer bir sorun, 21 Ekim'de yayımlanan Quant-Arena: Benchmarking LLM Agents for Quantitative Trading Research çalışmasında inceleniyor. Yazarlar, hisse senedi piyasasında nicel alım-satım stratejilerini bağımsız olarak geliştirebilen ve iyileştirebilen dokuz dil modelini test etti.
Modellere çözümlerini adım adım düzeltme izni verildiğinde, ortalama araştırma puanı yükseldi. Ancak mali sonuç dokuz modelin yalnızca dördünde iyileşti — diğer beşinde ise kötüleşti. Başka bir deyişle, daha başarılı bir araştırma süreci daha etkili bir stratejiye zorunlu olarak yol açmıyordu.
Bu deneyin genişletilmiş bir tartışması, HackerNoon'da yayımlanmak üzere hazırlanıyor.
İki çalışmanın karıştırılmaması önemlidir. Quant-Arena, dil modellerinin hisse senedi piyasasında kendi başlarına nicel araştırma yapma kapasitesini inceler. Ekim deneylerimiz ise Tantoryn AI bünyesindeki ML Setup Discovery ile ilgiliydi. Problem formülasyonu, yöntemler ve değerlendirme yordamları bakımından farklılık gösterirler. Ortak sorun başka yerdedir: yüksek araştırma metrikleri ve teknik olarak tamamlanmış deneyler, bir modelin ekonomik değerinin yeterli kanıtı değildir.
Araştırmayı, değerlendirmeyi ve risk yönetimini neden birbirinden ayırıyoruz
Tantoryn AI'da alım-satım örüntülerini aramak, araştırma adaylarını doğrulamak ve risk yönetimi farklı görevler olarak ele alınır. Bir araştırma sonucunun ilerideki kullanımını tartışmak için gerekçe doğmadan önce, öngörülen değerlendirmeden geçmesi gerekir.
Bu, makine öğrenmesinde özellikle önemlidir. Bir model, piyasa koşulları değiştiğinde ortadan kalkan istatistiksel bir bağımlılık yakalayabilir. Araştırma döneminde iyi çalışabilir, ancak bağımsız verilerde kalitesini koruyamayabilir. Son olarak, doğru bir tahmin bile alım-satım kısıtları hesaba katıldığında ekonomik üstünlük garanti etmez.
Bu yüzden eğitilen model sayısını veya tamamlanan deney sayısını tek başına bir ilerleme metriği saymıyoruz. Olumsuz bir sonuç da, doğru şekilde elde edilmişse ve haksız bir kararı elemaya yarıyorsa faydalı olabilir.
Tantoryn AI'ın güncel herkese açık alım-satım devresi sanal işlemler kullanır. Gerçek emirlerin işletilmesi devre dışıdır. Araştırma ve sanal işlem sonuçları, gerçek sermayeyle kârlılığın kanıtı değildir.
Araştırma sürecine ilişkin anlayışımızda ne değişti
Ekim deneyleri iki pratik gerekliliği netleştirmemizi sağladı.
Birincisi: her olumlu araştırma sonucu doğrulanabilir verilere dayanmalıdır. Bir yordamın biçimsel tamamlanması yetmez. Değerlendirmenin gerçekten yapıldığı ve sonucunun yorumlanabilir olduğu doğrulanmalıdır.
İkincisi: bir araştırma adayının, öngörülen kullanımla uyumlu kanıtlar taşıması gerekir. İyi bir eğitim metriği, sonucun kararlılığının ve ekonomik anlamının denetiminin yerine geçmez. Bu gereklilikler gelecekteki modellerin başarısını garanti etmez; ancak güvenilmez ya da yetersiz kanıtlara dayanarak karar verme riskini azaltır.
Sonuç
Ekim ayında Tantoryn AI, araştırılan ML Setup Discovery adaylarını yeni ve doğrulanmış alım-satım stratejileri ilan etmek için gerekçe elde etmedi. Bunun yerine, pratik açıdan önemli iki sonuç elde ettik. Birincisi, başarıyla eğitilmiş bir modelin yararlılığına dair yeterli kanıttan yoksun olabileceğinin teyidi. İkincisi, teknik olarak tamamlanmış bir doğrulamanın gerçek bir değerlendirme sağlamadığı bir veri hazırlığı hatasının keşfi.
Bu sonuçlar, Quant-Arena'nın gösterdiği daha geniş sorunla tutarlı: araştırma otomasyonu, ekonomik değerini güvenilir biçimde doğrulama yeteneğimizden daha hızlı ilerliyor. Bizim için alım-satım yapay zekâsını geliştirmek, yalnızca yeni örüntüler bulmak değil; henüz güvenilmeyecek sonuçları zamanında reddedebilmektir.
Bu materyal, Tantoryn AI'ın araştırma faaliyetini yansıtır. Anlatılan sonuçlar, alım-satım sisteminin kârlılığının kanıtı değildir ve yatırım tavsiyesi değildir.
Kaynaklar ve ilişkili materyaller
1. Houde Qian ve diğerleri. Quant-Arena: Benchmarking LLM Agents for Quantitative Trading Research. 21 Ekim 2026. Birincil çalışma.
2. Quant-Arena — projenin resmî sayfası. Deneysel ortamın ve sonuçların tanımı.
3. Sichun Luo ve diğerleri. AlphaQT-Bench: Diagnosing the Gap between Financial Code Generation and Quantitative Reasoning in LLMs. Findings of ACL 2026. Yürütülebilir kod ile doğru mali hesaplamalar arasındaki fark üzerine bir çalışma.