
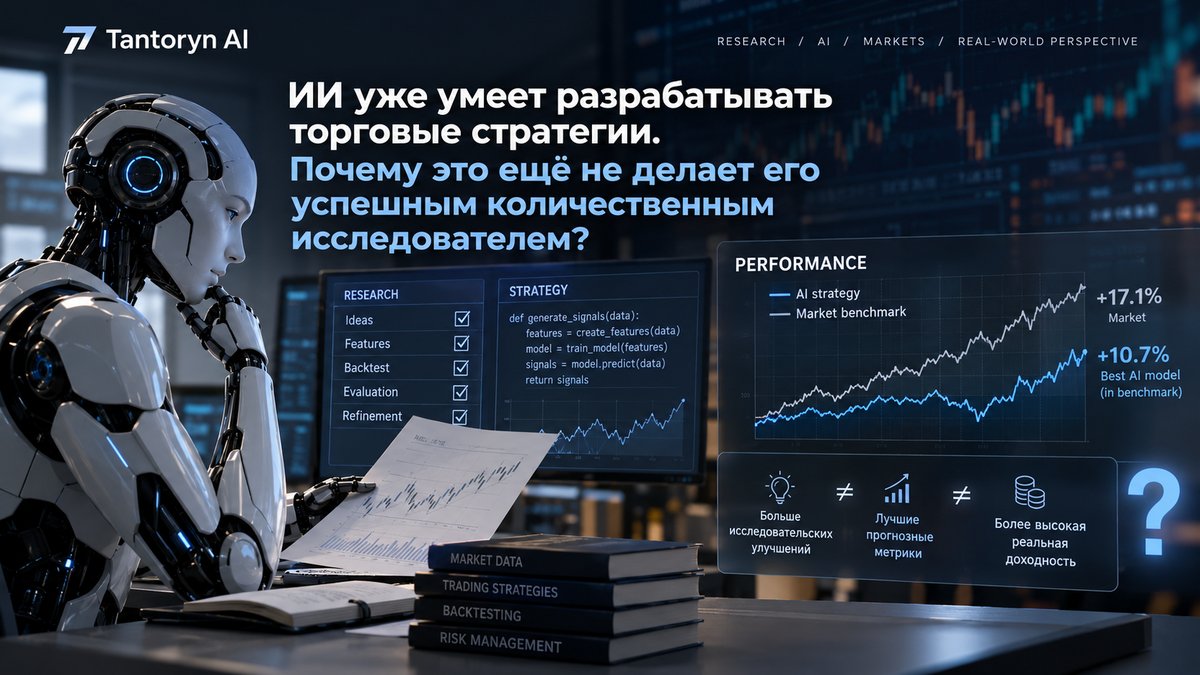
Искусственный интеллект способен создавать торговые гипотезы, обучать модели и анализировать результаты экспериментов. Однако успешное завершение вычислений ещё не означает, что обнаружена полезная рыночная закономерность.
В октябре 2026 года эта проблема проявилась в исследованиях Tantoryn AI. Мы проверяли новые подходы к поиску торговых закономерностей, получили отрицательные результаты и обнаружили ошибку в подготовке данных.
Эти события важны не потому, что привели к новой торговой стратегии, а потому, что показали, какие результаты нельзя принимать без дополнительной проверки.
Что мы исследовали
В начале октября работа велась в направлении ML Setup Discovery. Его задача — исследовать возможность выявления торговых закономерностей на основе описаний состояния рынка с помощью машинного обучения.
Это направление отличается от существующих детерминированных торговых семейств Tantoryn AI, где условия формирования кандидатов определяются заранее установленными правилами. В ML Setup Discovery исследуется другой подход: может ли модель обнаружить дополнительные закономерности в исторических рыночных состояниях.
Для этого недостаточно получить хороший показатель обучения. Необходимо установить, что обнаруженная зависимость сохраняется за пределами исследовательской выборки, не возникает из-за особенностей подготовки данных и имеет достаточные основания для дальнейшего рассмотрения. Именно на этих проверках возникли наиболее важные результаты.
Первый результат: обученная модель ещё не означает найденную закономерность
В ходе октябрьских экспериментов несколько исследовательских кандидатов прошли предусмотренные этапы обучения и технической проверки. Но завершение вычислений не стало основанием для их принятия.
В одних случаях результаты не позволяли обоснованно определить, как использовать полученные моделью оценки. В других имеющихся свидетельств было недостаточно, чтобы считать обнаруженную закономерность устойчивой. Такие кандидаты не получили допуска к дальнейшему применению.
Это отрицательный исследовательский результат, а не технический сбой обучения. Модель может корректно завершить работу, сформировать прогнозы и получить измеримые показатели, но не предоставить убедительных доказательств полезности этих прогнозов для торговых решений. В этом и состоит различие между успешным выполнением эксперимента и подтверждением исследовательской гипотезы. Первые итоги таких проверок мы описали в отдельном отчёте.
Для Tantoryn AI это различие принципиально: сам факт обучения модели не является достаточным основанием для изменения торговой системы.
Вторая проблема: проверки завершались без пригодных данных
Более существенная техническая проблема обнаружилась при подготовке данных. Часть проверок формально завершалась успешно, хотя подготовленные для соответствующей оценки данные не содержали пригодных наблюдений.
Это означало, что успешный технический статус нельзя интерпретировать как подтверждение качества модели. Возникла ситуация, при которой программа сообщала о завершении проверки, но фактических оснований для положительного исследовательского вывода не существовало.
Ошибка заключалась не в том, что модель показала слабый результат, а в том, что проверка могла завершиться без достаточных данных для его оценки. После обнаружения проблемы потребовалось исправить подготовку данных и повторно проверить соответствующие результаты.
Этот случай выявил важное требование к исследовательской инфраструктуре. Недостаточно контролировать только отсутствие программных ошибок. Необходимо отдельно устанавливать, что подготовленные данные действительно содержат пригодные наблюдения; что проверка выполнялась на предусмотренной выборке; что полученные показатели имеют определённый смысл; и что завершение процедуры не подменяет подтверждение исследовательского результата. Иначе автоматизация создаёт ложное ощущение надёжности.
Почему хорошие исследовательские метрики могут вводить в заблуждение
Похожая проблема рассматривается в опубликованном 21 октября исследовании Quant-Arena: Benchmarking LLM Agents for Quantitative Trading Research. Его авторы проверили девять языковых моделей, способных самостоятельно разрабатывать и улучшать количественные торговые стратегии на фондовом рынке.
Когда моделям разрешили последовательно исправлять свои решения, средняя исследовательская оценка выросла. Однако финансовый результат улучшился только у четырёх из девяти моделей. У остальных пяти он ухудшился. Иными словами, более успешный исследовательский процесс не обязательно приводил к более эффективной стратегии.
Мы подробно разобрали этот эксперимент в отдельной публикации: «ИИ научился создавать торговые стратегии. Но научился ли он зарабатывать?» — статья Tantoryn AI в Дзене.
Важно не смешивать два разных исследования. Quant-Arena изучает способность языковых моделей самостоятельно проводить количественные исследования на фондовом рынке. Наши октябрьские эксперименты касались ML Setup Discovery в Tantoryn AI. Они отличаются по постановке задачи, используемым методам и процедурам оценки. Общая проблема заключается в другом: высокие исследовательские показатели и технически завершённые эксперименты не являются достаточным доказательством экономической полезности модели.
Почему мы разделяем исследование, оценку и управление рисками
В Tantoryn AI поиск торговых закономерностей, проверка исследовательских кандидатов и управление рисками рассматриваются как разные задачи. Исследовательский результат должен пройти предусмотренную оценку, прежде чем появятся основания обсуждать его дальнейшее использование.
Это особенно важно при работе с машинным обучением. Модель может выявить статистическую зависимость, которая исчезает при изменении рыночных условий. Она может хорошо работать на исследовательском периоде, но не сохранять качество на независимых данных. Наконец, даже корректный прогноз не гарантирует экономического преимущества после учёта торговых ограничений.
Поэтому мы не рассматриваем количество обученных моделей или число завершённых экспериментов как самостоятельный показатель прогресса. Отрицательный результат тоже может быть полезным, если он получен корректно и позволяет исключить необоснованное решение.
При этом текущий публичный торговый контур Tantoryn AI использует виртуальные сделки. Исполнение реальных ордеров отключено. Результаты исследований и виртуальной торговли не являются подтверждением прибыльности при использовании реального капитала.
Что изменилось в понимании исследовательского процесса
Октябрьские эксперименты позволили уточнить два практических требования.
Первое: каждый положительный исследовательский вывод должен опираться на проверяемые данные. Формального завершения процедуры недостаточно. Необходимо убедиться, что оценка действительно состоялась и её результат можно интерпретировать.
Второе: исследовательский кандидат должен иметь доказательства, соответствующие предполагаемому применению. Хорошая метрика обучения не заменяет проверку устойчивости и экономического смысла результата. Эти требования не гарантируют, что будущие модели окажутся успешными, но позволяют уменьшить риск принятия решений на основании недостоверных или недостаточных свидетельств.
Заключение
В октябре Tantoryn AI не получил оснований объявлять исследованные ML Setup Discovery кандидаты новыми подтверждёнными торговыми стратегиями. Вместо этого мы получили два практически важных результата. Первый — подтверждение того, что успешно обученная модель может не обладать достаточными доказательствами полезности. Второй — обнаружение ошибки подготовки данных, при которой технически завершённая проверка не обеспечивала действительной оценки.
Эти результаты согласуются с более широкой проблемой, которую демонстрирует Quant-Arena: автоматизация исследований развивается быстрее, чем способность надёжно подтверждать их экономическую ценность. Для нас развитие торгового ИИ заключается не только в поиске новых закономерностей, но и в способности своевременно отклонять те результаты, которым пока нельзя доверять.
Материал отражает исследовательскую деятельность Tantoryn AI. Описанные результаты не являются доказательством прибыльности торговой системы или инвестиционной рекомендацией.
Источники и связанные материалы
1. Houde Qian и соавторы. Quant-Arena: Benchmarking LLM Agents for Quantitative Trading Research. 21 октября 2026 года. Основное исследование.
2. Quant-Arena — официальная страница проекта. Описание экспериментальной среды и результатов.
3. «ИИ научился создавать торговые стратегии. Но научился ли он зарабатывать?» — публикация Tantoryn AI в Дзене, 31 октября 2026 года.
4. Sichun Luo и соавторы. AlphaQT-Bench: Diagnosing the Gap between Financial Code Generation and Quantitative Reasoning in LLMs. Findings of ACL 2026. Исследование различий между исполняемым кодом и корректными финансовыми вычислениями.