
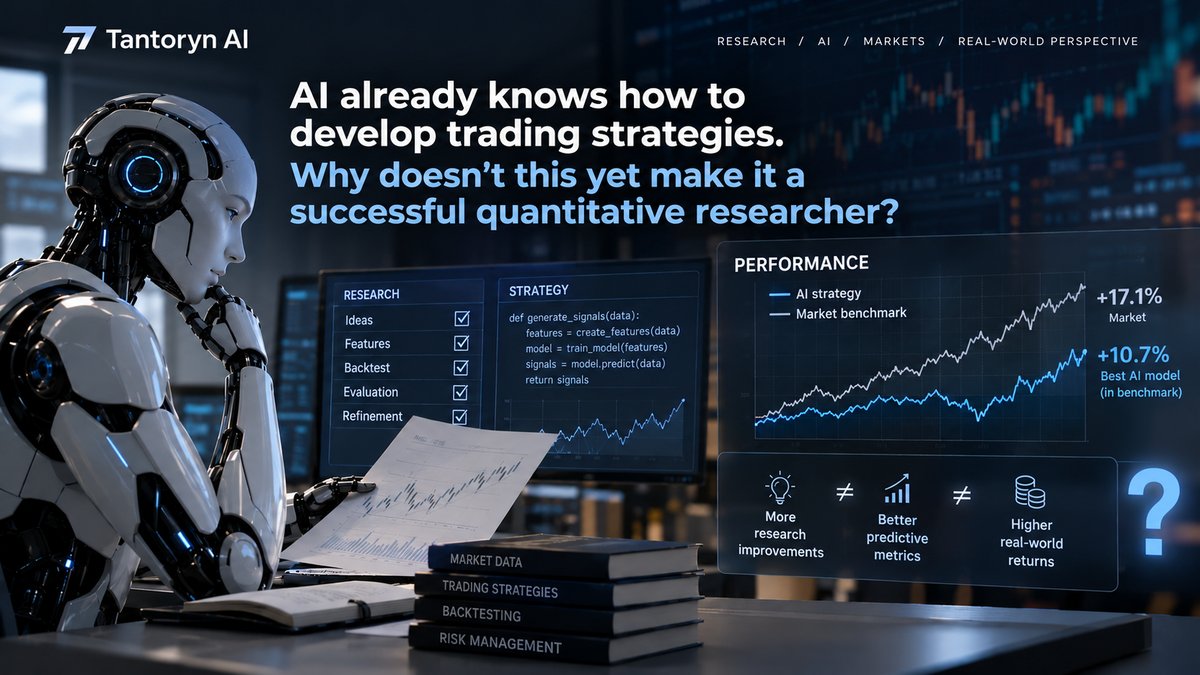
A inteligência artificial é capaz de criar hipóteses de trading, treinar modelos e analisar resultados de experimentos. No entanto, a conclusão bem-sucedida de um cálculo não significa que um padrão de mercado útil tenha sido descoberto.
Em outubro de 2026, esse problema se manifestou nas pesquisas da Tantoryn AI. Estávamos testando novas abordagens para encontrar padrões de trading, obtivemos resultados negativos e descobrimos um erro na preparação dos dados.
Esses eventos importam não porque tenham levado a uma nova estratégia de trading, mas porque mostraram quais resultados não podem ser aceitos sem verificação adicional.
O que estávamos pesquisando
No início de outubro, o trabalho seguia a direção de ML Setup Discovery. Seu objetivo é investigar se o aprendizado de máquina pode identificar padrões de trading a partir de descrições do estado do mercado.
Essa direção difere das famílias de trading determinísticas existentes na Tantoryn AI, nas quais as condições de formação dos candidatos são definidas por regras preestabelecidas. O ML Setup Discovery investiga uma pergunta diferente: um modelo pode descobrir padrões adicionais em estados históricos do mercado?
Para isso, uma boa métrica de treinamento não basta. É preciso estabelecer que a dependência descoberta se mantém além da amostra de pesquisa, que não surge de particularidades da preparação dos dados e que oferece fundamentos suficientes para consideração posterior. Os resultados mais importantes surgiram justamente nessas verificações.
Primeiro resultado: um modelo treinado ainda não significa um padrão descoberto
Durante os experimentos de outubro, vários candidatos de pesquisa passaram pelas etapas prescritas de treinamento e validação técnica. Mas a conclusão dos cálculos não se tornou motivo para aceitá-los.
Em alguns casos, os resultados não permitiam decidir de forma fundamentada como usar as pontuações produzidas pelo modelo. Em outros, as evidências disponíveis eram insuficientes para considerar o padrão descoberto estável. Esses candidatos não foram admitidos para uso posterior.
Este é um resultado de pesquisa negativo, não uma falha técnica de treinamento. Um modelo pode concluir corretamente sua execução, produzir previsões e obter métricas mensuráveis, e ainda assim não fornecer evidências convincentes de que essas previsões são úteis para decisões de trading. Essa é a diferença entre executar um experimento com sucesso e confirmar uma hipótese de pesquisa. Os primeiros resultados dessas verificações foram descritos em um relatório separado.
Para a Tantoryn AI, essa distinção é fundamental: o mero fato de um modelo ter sido treinado não é base suficiente para alterar o sistema de trading.
Segundo problema: verificações concluídas sem dados utilizáveis
O problema técnico mais significativo apareceu na preparação dos dados. Algumas verificações se concluíam formalmente com sucesso, embora os dados preparados para a avaliação correspondente não contivessem observações utilizáveis.
Isso significava que um status técnico de sucesso não podia ser interpretado como confirmação da qualidade do modelo. O programa relatava uma verificação concluída, mas não existia base real para uma conclusão de pesquisa positiva.
O erro não estava em o modelo ter apresentado um resultado fraco, mas em o fato de uma verificação poder se concluir sem dados suficientes para avaliá-lo. Após a descoberta do problema, foi necessário corrigir a preparação dos dados e verificar novamente os resultados correspondentes.
Esse caso revelou um requisito importante para a infraestrutura de pesquisa. Não basta verificar apenas a ausência de erros de software. Também é preciso estabelecer separadamente que os dados preparados realmente contêm observações utilizáveis; que a verificação foi executada na amostra prevista; que as métricas obtidas têm um significado definido; e que a conclusão de um procedimento não substitui a confirmação de um resultado de pesquisa. Caso contrário, a automação cria uma falsa sensação de confiabilidade.
Por que boas métricas de pesquisa podem induzir ao erro
Um problema semelhante é examinado no estudo Quant-Arena: Benchmarking LLM Agents for Quantitative Trading Research, publicado em 21 de outubro. Seus autores testaram nove modelos de linguagem capazes de desenvolver e aprimorar estratégias quantitativas de trading de forma independente no mercado de ações.
Quando os modelos puderam corrigir suas soluções passo a passo, a pontuação média de pesquisa subiu. No entanto, o resultado financeiro melhorou em apenas quatro dos nove modelos — e piorou nos outros cinco. Em outras palavras, um processo de pesquisa mais bem-sucedido não levava necessariamente a uma estratégia mais eficaz.
Uma discussão ampliada deste experimento está sendo preparada para publicação na HackerNoon.
É importante não confundir os dois estudos. O Quant-Arena examina a capacidade dos modelos de linguagem de conduzir pesquisas quantitativas por conta própria no mercado de ações. Nossos experimentos de outubro diziam respeito ao ML Setup Discovery na Tantoryn AI. Eles diferem na formulação do problema, nos métodos e nos procedimentos de avaliação. O problema comum está em outro lugar: métricas de pesquisa elevadas e experimentos tecnicamente concluídos não são prova suficiente do valor econômico de um modelo.
Por que mantemos separadas a pesquisa, a avaliação e a gestão de riscos
Na Tantoryn AI, a busca por padrões de trading, a validação dos candidatos de pesquisa e a gestão de riscos são tratadas como tarefas diferentes. Um resultado de pesquisa precisa passar pela avaliação prescrita antes que haja fundamentos para discutir seu uso posterior.
Isso é especialmente importante no aprendizado de máquina. Um modelo pode detectar uma dependência estatística que desaparece quando as condições de mercado mudam. Pode ir bem no período de pesquisa e não manter a qualidade em dados independentes. E, por fim, mesmo uma previsão correta não garante vantagem econômica depois de consideradas as restrições de trading.
Por isso, não tratamos o número de modelos treinados ou de experimentos concluídos como métrica de progresso por si só. Um resultado negativo também pode ser útil quando obtido corretamente e permite descartar uma decisão injustificada.
O atual circuito público de trading da Tantoryn AI opera com operações virtuais. A execução de ordens reais está desativada. Os resultados da pesquisa e do trading virtual não são prova de rentabilidade com capital real.
O que mudou na nossa compreensão do processo de pesquisa
Os experimentos de outubro permitiram precisar dois requisitos práticos.
Primeiro: cada conclusão positiva de pesquisa deve se apoiar em dados verificáveis. A conclusão formal de um procedimento não é suficiente. É preciso confirmar que a avaliação de fato ocorreu e que seu resultado pode ser interpretado.
Segundo: um candidato de pesquisa precisa trazer evidências compatíveis com o uso pretendido. Uma boa métrica de treinamento não substitui a verificação da estabilidade e do sentido econômico do resultado. Esses requisitos não garantem que os modelos futuros serão bem-sucedidos, mas reduzem o risco de tomar decisões com base em evidências não confiáveis ou insuficientes.
Conclusão
Em outubro, a Tantoryn AI não obteve fundamentos para declarar os candidatos pesquisados de ML Setup Discovery novas estratégias de trading confirmadas. Em vez disso, obtivemos dois resultados praticamente importantes. O primeiro é a confirmação de que um modelo bem treinado pode não dispor de evidências suficientes de utilidade. O segundo é a descoberta de um erro de preparação dos dados no qual uma verificação tecnicamente concluída não constituía uma avaliação real.
Esses resultados são consistentes com o problema mais amplo que o Quant-Arena demonstra: a automação da pesquisa avança mais rápido do que a nossa capacidade de confirmar de forma confiável seu valor econômico. Para nós, desenvolver IA de trading não é apenas encontrar novos padrões, mas também ter a capacidade de rejeitar em tempo hábil os resultados em que ainda não se pode confiar.
Este material reflete a atividade de pesquisa da Tantoryn AI. Os resultados descritos não são prova da rentabilidade do sistema de trading nem constituem recomendação de investimento.
Fontes e materiais relacionados
1. Houde Qian et al. Quant-Arena: Benchmarking LLM Agents for Quantitative Trading Research. 21 de outubro de 2026. O estudo principal.
2. Quant-Arena — página oficial do projeto. Descrição do ambiente experimental e dos resultados.
3. Sichun Luo et al. AlphaQT-Bench: Diagnosing the Gap between Financial Code Generation and Quantitative Reasoning in LLMs. Findings of ACL 2026. Um estudo sobre a distância entre código executável e cálculos financeiros corretos.